Ricerca
Skill2Real: apprendimento agentico di abilità per la manipolazione robotica dalla simulazione alla realtà in modalità zero-shot
Trasferire abilità robotiche dalla simulazione alla realtà richiede conoscenze relative al compito che restino utilizzabili nonostante le differenze nella percezione, nella dinamica e nella struttura
- arXiv
- 2610.02788
- Pubblicato
- 2026-10-02
- Autori
- Xincheng He, Siyu Ma, Chang Yu, Yunuo Chen, Yanjia Huang, Ying Nian Wu, Yin Yang, Chenfanfu Jiang
Abstract degli autori
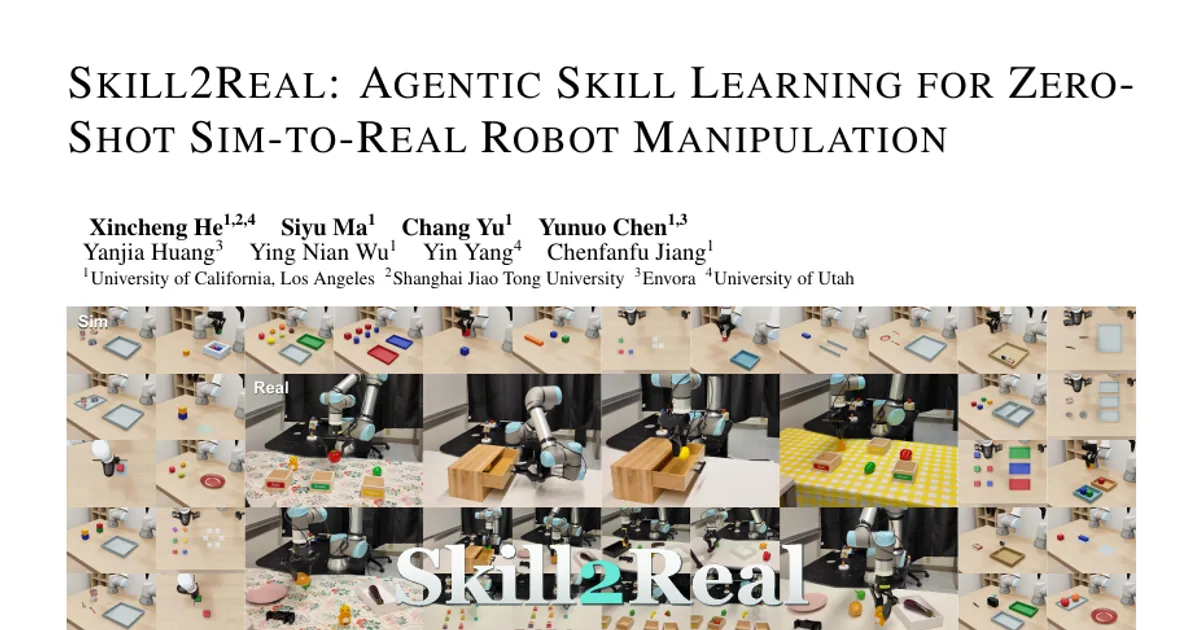
Trasferire abilità robotiche dalla simulazione alla realtà richiede conoscenze relative al compito che restino utilizzabili nonostante le differenze nella percezione, nella dinamica e nella struttura fisica del robot. Presentiamo Skill2Real, un framework agentico per le policy che apprende abilità eseguibili attraverso un’interfaccia di programmazione delle applicazioni (API) condivisa. Un ciclo Proposer-Verifier-Governor (PVG) usa le informazioni privilegiate della simulazione per analizzare gli esiti e convalidare gli aggiornamenti, mantenendo le abilità apprese ancorate alle osservazioni pubbliche e alla semantica dell’API. Il Cerebellum acquisisce dapprima abilità locali di manipolazione; il Brain apprende poi a combinarle a livello di compito, mentre il Cerebellum resta congelato. Entrambe le memorie vengono trasferite al robot reale senza fine-tuning della policy per il compito né aggiornamenti della memoria delle abilità. Mentre GPT-5.6 Sol apprende abilità su LIBERO-90, valutare ciascun checkpoint congelato con GPT-6 Astra porta il tasso di successo su LIBERO-Pro Long dal 2,0% al 56,3%, senza addestramento su Pro Long. Un addestramento indipendente su Robosuite raggiunge tassi medi di successo dell’85,1% con Sol e dell’89,4% con Opus 5 su sette compiti, rispettivamente. Le abilità apprese su LIBERO-90 con Sol e poi congelate raggiungono, con Astra, un tasso medio di completamento del 78,75% in quattro compiti di manipolazione nel mondo reale. Eliminare il Verifier o il Governor durante l’addestramento su LIBERO-90 riduce il tasso di successo finale su Pro Long rispettivamente di 17,3 e 13,3 punti percentuali. Questi risultati sostengono l’apprendimento e il trasferimento di una gerarchia di abilità eseguibili attraverso un’interfaccia robotica comune.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv