Ricerca
Sei livelli in meno: potatura dell’encoder per Whisper con recupero senza etichette
La potatura di grandi modelli ASR basati su transformer e preaddestrati, come Whisper di OpenAI, è stata ampiamente adottata, poiché la potatura del decoder ha portato a significativi aumenti della ve
- arXiv
- 2609.27980
- Pubblicato
- 2026-09-23
- Autori
- Rasmus Aagaard, Nicki Skafte Detlefsen
Abstract degli autori
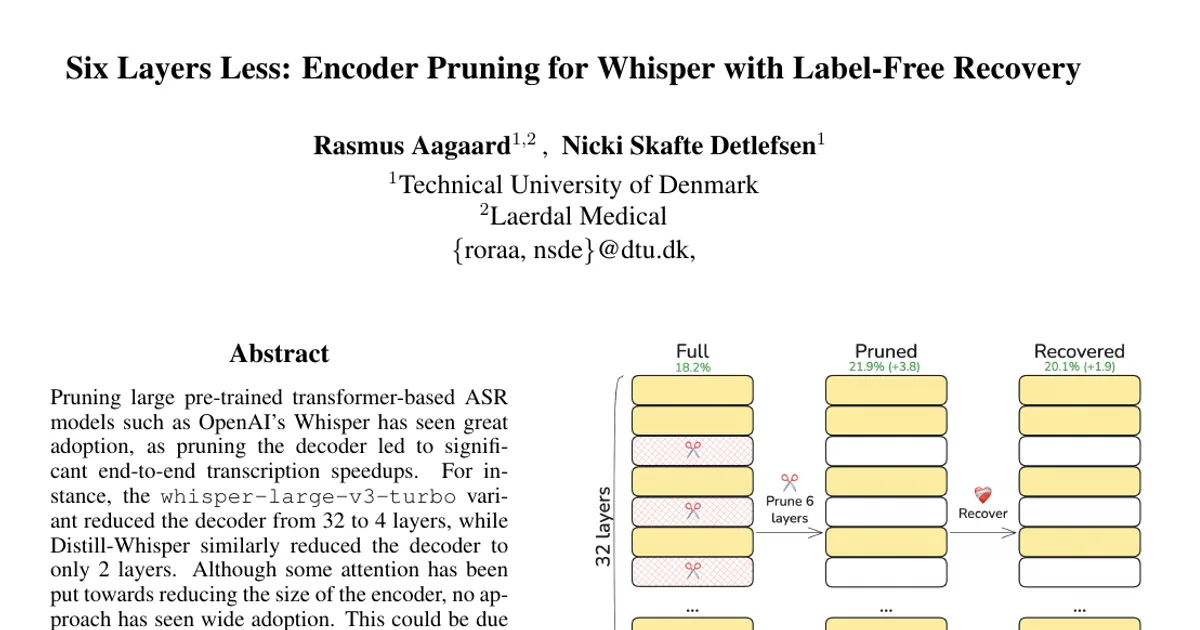
La potatura di grandi modelli ASR basati su transformer e preaddestrati, come Whisper di OpenAI, è stata ampiamente adottata, poiché la potatura del decoder ha portato a significativi aumenti della velocità di trascrizione end-to-end. Per esempio, la variante {\tt whisper-large-v3-turbo} ha ridotto il decoder da 32 a 4 livelli, mentre Distill-Whisper lo ha ridotto a soli 2 livelli. Sebbene si sia prestata una certa attenzione alla riduzione delle dimensioni dell’encoder, nessun approccio ha conosciuto un’ampia adozione. Ciò potrebbe dipendere dalla necessità di implementazioni di inferenza personalizzate per sfruttare il modello compresso. Presentiamo un approccio che classifica i livelli dell’encoder in base alla variazione del Word Error Rate (WER) quando si esclude un livello alla volta. Vengono rimossi i sei livelli che causano la variazione minore, pari al $18.5\%$ dell’encoder. Il modello potato non richiede codice di inferenza personalizzato, perché è semplicemente un encoder più compatto, con meno livelli. Inoltre, usiamo dati vocali monolingui non etichettati per distillare il modello e recuperare le prestazioni perse a causa della potatura zero-shot dei livelli. Il WER medio su quattro lingue sale al $20.1\%$ dopo la distillazione, rispetto al $21.9\%$ in modalità zero-shot, partendo da un valore di riferimento del $18.2\%$. Rilasciamo tutto il nostro codice (https://github.com/rasgaard/whisper-encoder-layer-prune) e il modello potato (https://huggingface.co/rasgaard/whisper-large-v3-turbo-encoder-pruned).
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv