Ricerca
SanSi: un modello decisionale tipizzato a cicli per il pensiero System 1.5
I modelli decisionali tipizzati rispondono a una domanda dichiarata senza generare testo: una testa decisionale restituisce, in un solo passaggio in avanti, una probabilità per ciascuna delle opzioni
- arXiv
- 2610.07730
- Pubblicato
- 2026-10-06
- Autori
- Shuyu Gan, Young-Jun Lee, Dongyeop Kang
Abstract degli autori
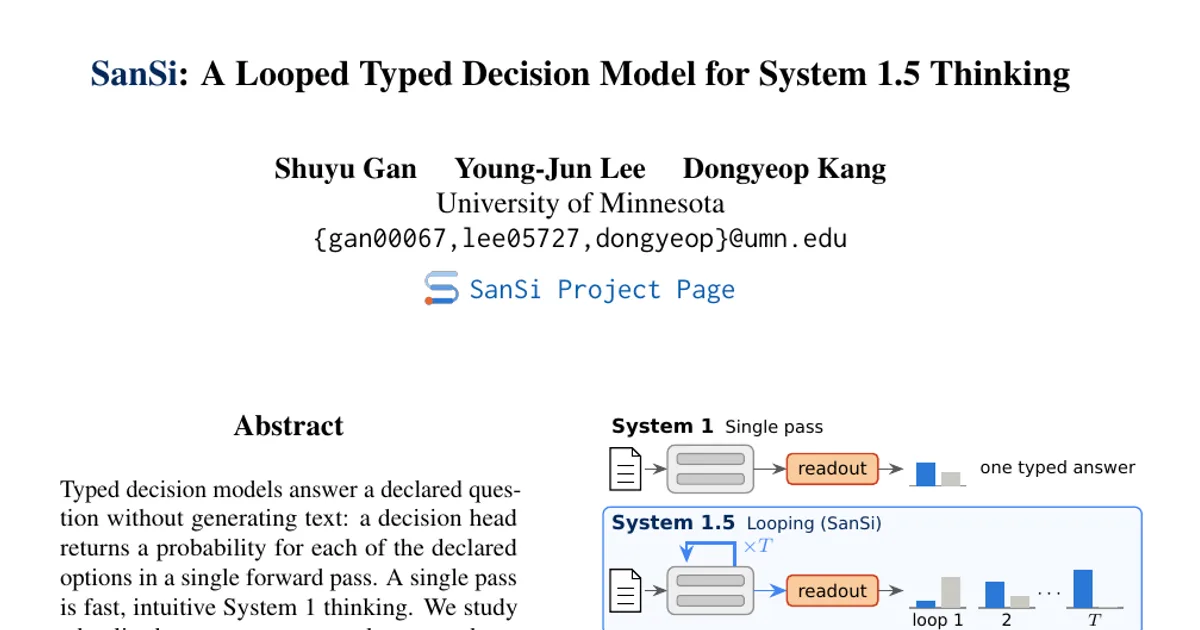
I modelli decisionali tipizzati rispondono a una domanda dichiarata senza generare testo: una testa decisionale restituisce, in un solo passaggio in avanti, una probabilità per ciascuna delle opzioni dichiarate. Un solo passaggio è un pensiero System 1 rapido e intuitivo. Studiamo ciò che si colloca tra un singolo passaggio e il ragionamento generato: i cicli, nei quali gli stessi strati vengono applicati ricorsivamente più volte prima di un’unica lettura tipizzata. Ogni ciclo permette al modello di rivedere il proprio stato nascosto prima di impegnarsi in una risposta, senza generare alcun token: chiamiamo questo processo pensiero System 1.5. Proponiamo SanSi, che trasforma un modello linguistico preaddestrato a cicli in un modello decisionale tipizzato. Le probabilità delle opzioni vengono lette dopo ogni ciclo, e ogni ciclo viene addestrato con una regola di scoring propria: così, in un’unica esecuzione, un solo modello copre ogni budget da uno a otto cicli. Su 10.027 decisioni di test provenienti da 59 fonti, SanSi raggiunge un’accuratezza del 72,0%: 13,5 punti in più rispetto a un modello senza cicli della stessa struttura, addestrato con la stessa procedura; 5,3 punti in più rispetto a un modello senza cicli più recente e della stessa dimensione; e 1,8 punti in meno rispetto a un modello con un numero di parametri triplo. In due compiti a profondità controllata, i cicli estendono la profondità risolvibile oltre quelle osservate durante l’addestramento, dove il modello più grande a passaggio singolo fallisce. Usato come giudice per l’ottimizzazione della policy mediante apprendimento per rinforzo, senza risposte di riferimento, SanSi aumenta di 7,7 punti l’F1 del generatore.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv