Ricerca
SAGE: Semantic Anchor-Guided Evolution per la sintesi di dati per la risposta a domande mediche ancorata a riferimenti
Lo sviluppo di modelli affidabili per compiti clinici, come la risposta a domande mediche (QA), è fortemente limitato dalla scarsa disponibilità di dati di addestramento di alta qualità annotati da es
- arXiv
- 2610.08093
- Pubblicato
- 2026-10-06
- Autori
- Chuan Li, Chengyu Wang, Cen Chen, Ye Lyu, Mingyuan Fan, Ming Gao
Abstract degli autori
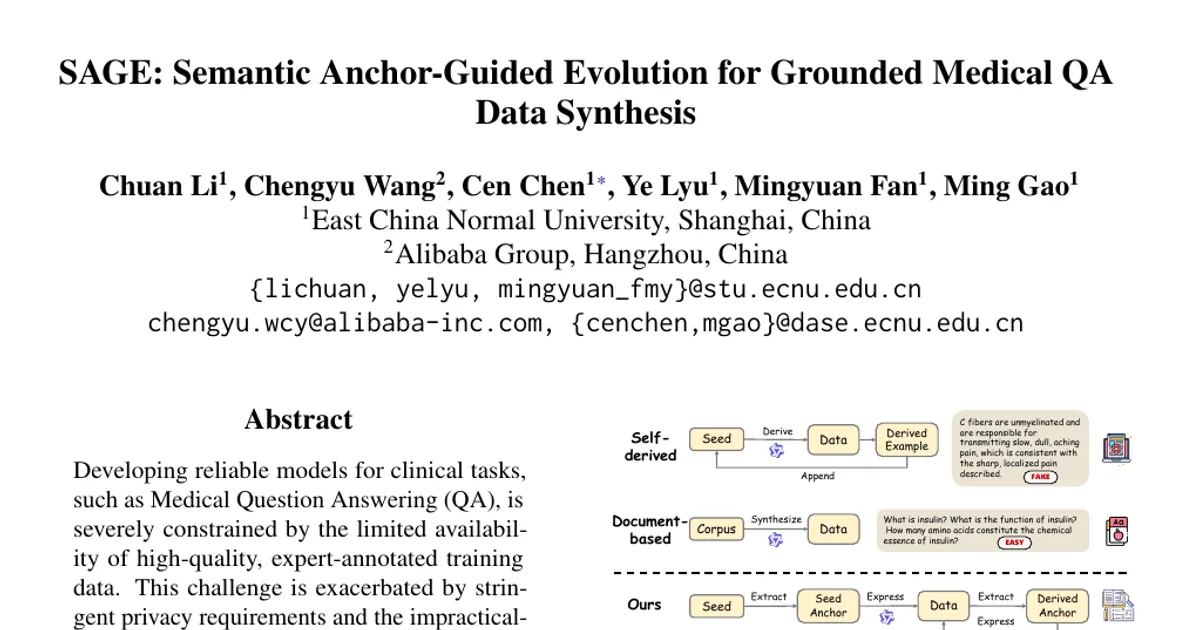
Lo sviluppo di modelli affidabili per compiti clinici, come la risposta a domande mediche (QA), è fortemente limitato dalla scarsa disponibilità di dati di addestramento di alta qualità annotati da esperti. La difficoltà è aggravata dai rigorosi requisiti di tutela della privacy e dall’impraticabilità dell’uso di grandi corpora open source o di API cloud proprietarie in contesti clinici con risorse limitate. Per superare questi ostacoli, presentiamo SAGE (\textit{Semantic Anchor-Guided Evolution}), un nuovo framework per la sintesi di dati che consente a modelli di piccole dimensioni, installati localmente, di generare dati di addestramento medico di alta qualità. SAGE usa tassonomie leggere e disponibili pubblicamente, come MeSH, come ancore semantiche: impone così una struttura a priori che guida efficacemente il processo di generazione dei dati e lo ancora a riferimenti. Il nucleo di SAGE è un processo iterativo che alterna la sintesi atomica (basata su singoli concetti) e quella associativa (basata sulle relazioni), generando progressivamente dati di addestramento a partire da un insieme minimo di dati iniziali. Questo approccio elimina la necessità di grandi raccolte di documenti medici e la dipendenza da API esterne, offrendo una soluzione pratica per creare dati nelle strutture stesse. Ampi esperimenti su diversi benchmark di risposta a domande mediche mostrano che i modelli sottoposti a fine-tuning con dati sintetizzati da SAGE superano sistematicamente quelli addestrati con approcci basati su dati autogenerati o con approcci convenzionali basati su documenti. I risultati evidenziano miglioramenti concreti nell’efficienza d’uso dei dati e nell’utilizzo delle risorse per lo sviluppo di LLM medici. Il codice è disponibile all’indirizzo https://github.com/DIaacKr/SAGE.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv