Ricerca
Ripensare la compressione delle sequenze con la regressione in fase di test
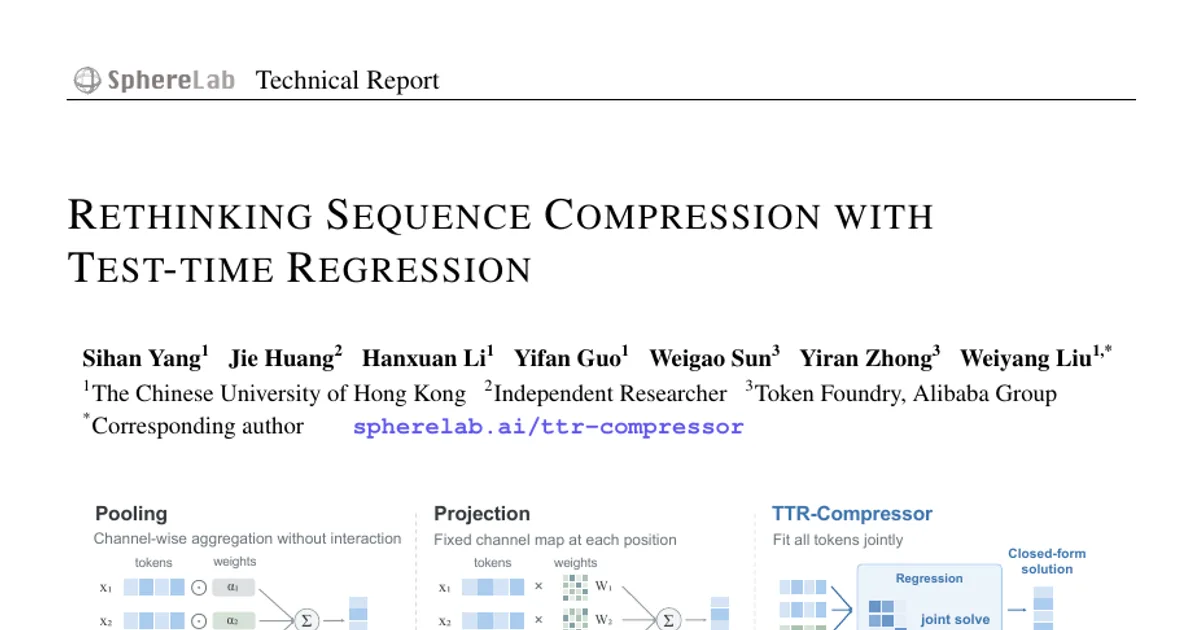
La compressione delle sequenze è un’operazione fondamentale e un collo di bottiglia critico per l’informazione nei modelli linguistici e multimodali efficienti. Eppure, gli approcci prevalenti basati
- arXiv
- 2610.31574
- Pubblicato
- 2026-10-22
- Autori
- Sihan Yang, Jie Huang, Hanxuan Li, Yifan Guo, Weigao Sun, Yiran Zhong, Weiyang Liu
Abstract degli autori
La compressione delle sequenze è un’operazione fondamentale e un collo di bottiglia critico per l’informazione nei modelli linguistici e multimodali efficienti. Eppure, gli approcci prevalenti basati sul pooling o su proiezioni apprese continuano a offrire prestazioni inferiori alle attese. Riesaminiamo la compressione delle sequenze attraverso la regressione in fase di test: i token in ingresso definiscono un problema di regressione i cui coefficienti stimati costituiscono la rappresentazione compressa. È importante notare che il problema di regressione viene appreso end-to-end mediante backpropagation, mentre i suoi coefficienti vengono calcolati efficientemente in forma chiusa durante il passaggio in avanti. Nasce così TTR-Compressor, un’alternativa generale alla compressione convenzionale basata su pooling e proiezioni. Valutiamo TTR-Compressor come compressore per l’attenzione sparsa a blocchi e come modulo di fusione dei token visivi per i modelli linguistici di grandi dimensioni multimodali. Nell’attenzione sparsa a blocchi, TTR-Compressor migliora le prestazioni su RULER con un ampio margine rispetto ai compressori basati sull’attenzione. Nella fusione dei token visivi, supera sistematicamente il modulo standard di fusione MLP e ne eguaglia le prestazioni con il 55,6% di token visivi in meno. Questi risultati mostrano che la regressione in fase di test è un meccanismo efficace per comprimere le sequenze nei modelli linguistici e multimodali efficienti.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv