Ricerca
RelightFormer: transformer generativo feed-forward per la ri-illuminazione di oggetti da più viste
La ri-illuminazione delle immagini viene tradizionalmente affrontata con complesse pipeline di rendering inverso, soggette a problemi di ottimizzazione mal posti, oppure con modelli generativi basati
- arXiv
- 2609.07414
- Pubblicato
- 2026-09-07
- Autori
- Hejun Wang, Jinxi Li, Junwei Jiang, Shiwei Mao, Hu Cheng, Shouwang Huang, Bo Yang
Abstract degli autori
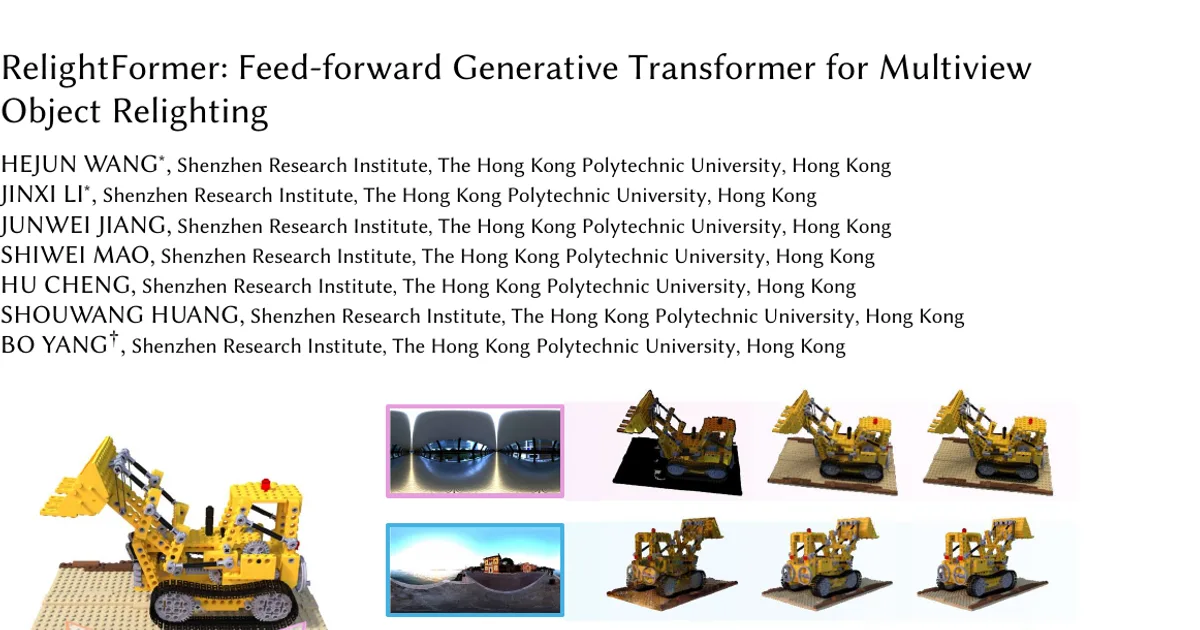
La ri-illuminazione delle immagini viene tradizionalmente affrontata con complesse pipeline di rendering inverso, soggette a problemi di ottimizzazione mal posti, oppure con modelli generativi basati su una singola immagine, che ignorano gli indizi fondamentali offerti da più viste per comprendere la geometria 3D e le interazioni tra materiali. Per superare questi limiti, presentiamo un transformer generativo feed-forward per la ri-illuminazione diretta di immagini da una o più viste, che evita del tutto la stima esplicita delle proprietà intrinseche. Adattata da un modello di base per i video, la nostra architettura include un modulo di illuminazione latente che integra dinamicamente le mappe ambientali di destinazione nelle caratteristiche spaziali tramite cross-attention. Inoltre, impieghiamo codifiche posizionali invarianti rispetto alle permutazioni per elaborare simmetricamente gli input da più viste privi di ordine, senza distorsioni dovute alla sequenza. Per addestrare questo solido modello basato sui dati, creiamo il vasto Laval Objaverse Dataset (LOD), che comprende 90K oggetti e 39K illuminazioni distinte. Esperimenti approfonditi dimostrano una qualità visiva all’avanguardia, una qualità fotorealistica della ri-illuminazione e una forte capacità di generalizzazione zero-shot nei compiti di ri-illuminazione da una singola vista, da più viste e da viste inedite.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv