Ricerca
Un harness ricorrente per l’apprendimento continuo degli agenti
Gli agenti basati su modelli linguistici operano sempre più spesso su lunghe sequenze di interazioni e devono adattarsi online ai cambiamenti nella distribuzione dei dati attraverso l’apprendimento co
- arXiv
- 2610.12668
- Pubblicato
- 2026-10-08
- Autori
- Yuxin Xiao, Zhiyun Lu, Jianyu Wang, Yangtian Zhang, Yang Song, Qifan Wang, Bailin Wang
Abstract degli autori
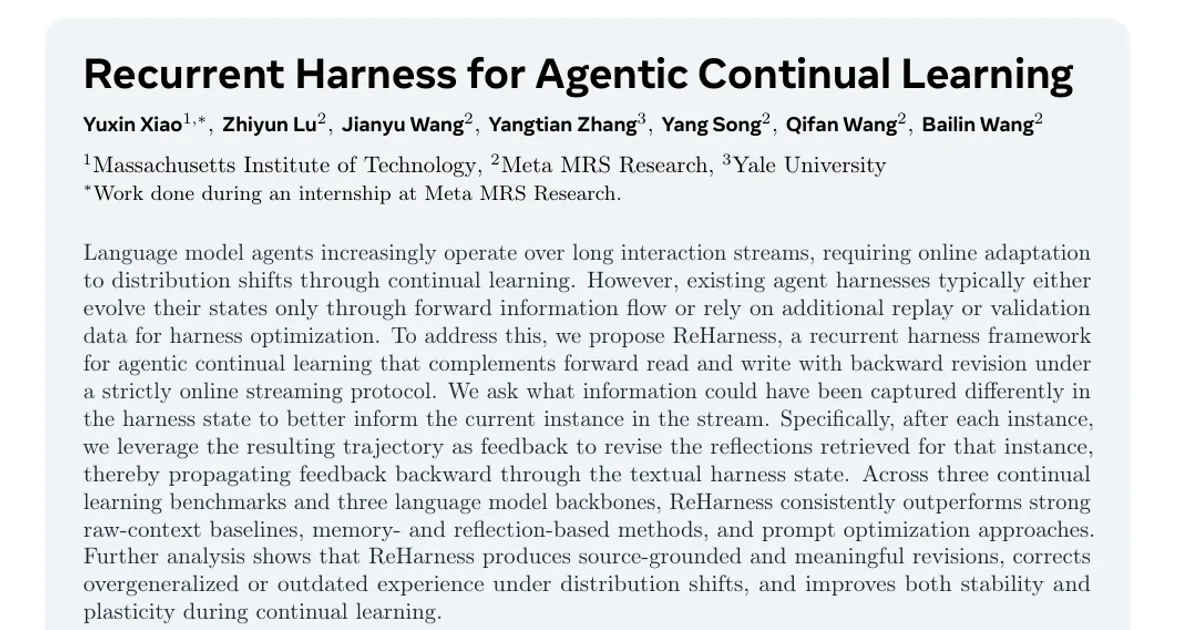
Gli agenti basati su modelli linguistici operano sempre più spesso su lunghe sequenze di interazioni e devono adattarsi online ai cambiamenti nella distribuzione dei dati attraverso l’apprendimento continuo. Tuttavia, gli harness esistenti per gli agenti in genere aggiornano il proprio stato soltanto mediante un flusso di informazioni in avanti, oppure richiedono dati aggiuntivi di replay o di validazione per ottimizzare l’harness. Per affrontare questo limite, proponiamo ReHarness, un framework di harness ricorrente per l’apprendimento continuo degli agenti che affianca alla lettura e alla scrittura in avanti una revisione a ritroso, secondo un protocollo di streaming rigorosamente online. Ci chiediamo quali informazioni si sarebbero potute acquisire in modo diverso nello stato dell’harness per orientare meglio l’elaborazione dell’istanza corrente nella sequenza. Nello specifico, dopo ogni istanza, usiamo la traiettoria risultante come feedback per rivedere le riflessioni recuperate per quell’istanza, propagando così il feedback a ritroso attraverso lo stato testuale dell’harness. Su tre benchmark di apprendimento continuo e tre modelli linguistici di base, ReHarness supera sistematicamente solidi metodi di riferimento basati sul contesto grezzo, metodi basati sulla memoria e sulla riflessione e approcci di ottimizzazione dei prompt. Un’ulteriore analisi mostra che ReHarness produce revisioni significative e fondate sulle fonti, corregge esperienze generalizzate eccessivamente o divenute obsolete a seguito dei cambiamenti nella distribuzione dei dati e migliora sia la stabilità sia la plasticità durante l’apprendimento continuo.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv