Ricerca
Recuperare una supervisione affidabile con la distillazione on-policy guidata dalla critica
La distillazione on-policy (OPD) addestra un modello studente sui propri rollout, con una supervisione a livello di token fornita da un modello insegnante, presupponendo che quest’ultimo possa arrivar
- arXiv
- 2610.20572
- Pubblicato
- 2026-10-14
- Autori
- Kaixiang Zhao, Tianrun Yu, Shangzhe Li, Yuxiao Yang, Amanda Hughes, Weitong Zhang, Taylor W. Killian
Abstract degli autori
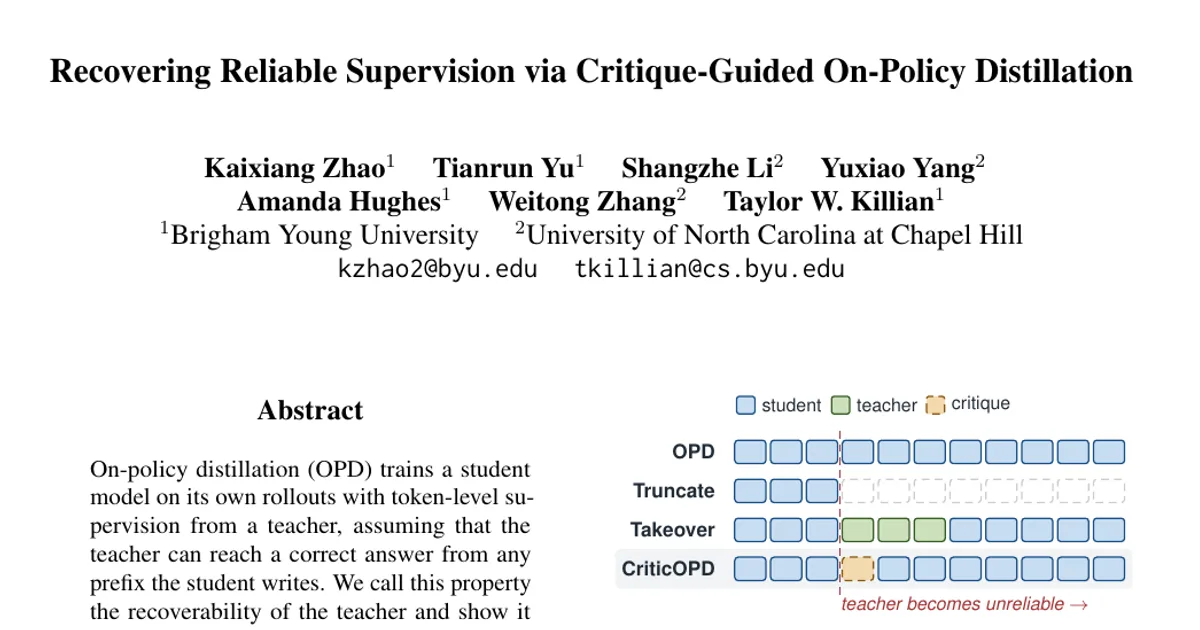
La distillazione on-policy (OPD) addestra un modello studente sui propri rollout, con una supervisione a livello di token fornita da un modello insegnante, presupponendo che quest’ultimo possa arrivare a una risposta corretta a partire da qualsiasi prefisso scritto dallo studente. Chiamiamo questa proprietà recuperabilità dell’insegnante e mostriamo che viene meno nei rollout errati: l’insegnante segue gli errori dello studente, pur riconoscendoli. Proponiamo CriticOPD, che sfrutta il riconoscimento degli errori per ripristinare la recuperabilità. L’insegnante critica un rollout errato, consentendo allo studente di riscrivere la propria soluzione dopo l’errore. L’output risultante, che include la critica come informazione privilegiata, viene valutato dall’insegnante, mentre lo studente usa la versione rivista senza la critica per l’addestramento. Su due modelli studenti Qwen3 e sei benchmark di ragionamento matematico, CriticOPD migliora i risultati dell’OPD, con i progressi maggiori nei problemi da competizione.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv