Ricerca
Riconoscere l’ambiguità nei dialoghi attraverso il grounding visivo dell’insieme dei candidati
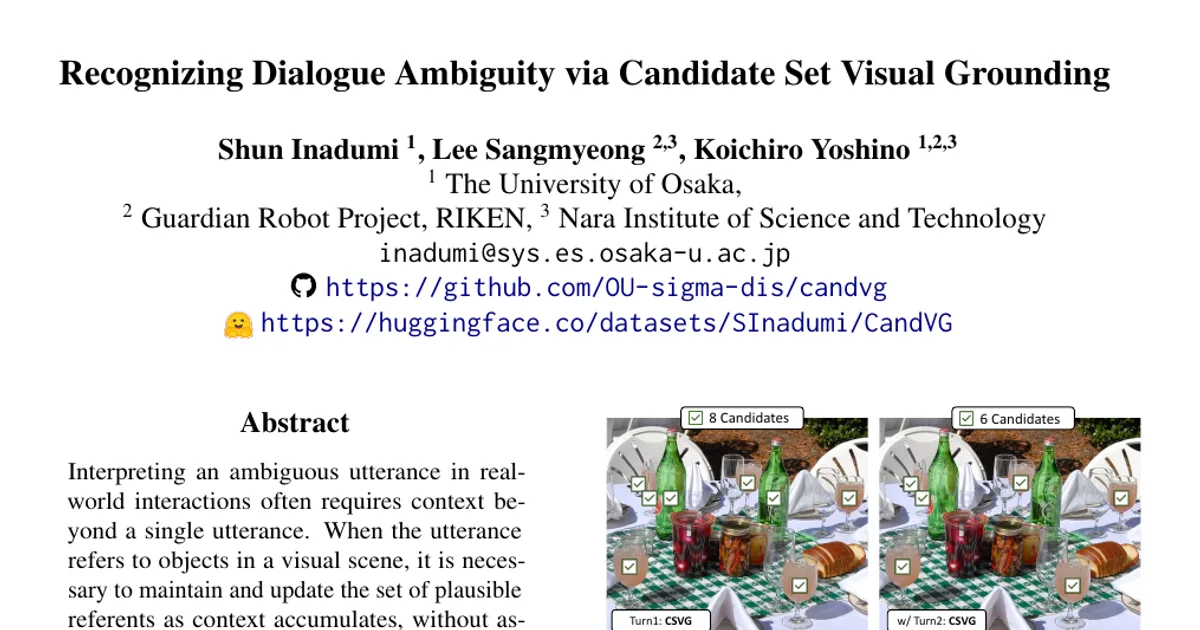
Interpretare un enunciato ambiguo nelle interazioni reali richiede spesso un contesto che vada oltre il singolo enunciato. Quando l’enunciato si riferisce a oggetti in una scena visiva, è necessario m
- arXiv
- 2610.19723
- Pubblicato
- 2026-10-14
- Autori
- Shun Inadumi, Lee Sangmyeong, Koichiro Yoshino
Abstract degli autori
Interpretare un enunciato ambiguo nelle interazioni reali richiede spesso un contesto che vada oltre il singolo enunciato. Quando l’enunciato si riferisce a oggetti in una scena visiva, è necessario mantenere e aggiornare l’insieme dei possibili referenti man mano che il contesto si arricchisce, senza presumere che le informazioni disponibili identifichino un unico oggetto. Tuttavia, i lavori precedenti sul grounding visivo interattivo, che localizza gli oggetti a cui si riferiscono le espressioni linguistiche, si sono concentrati sull’identificazione di un unico oggetto una volta disponibile un contesto dialogico sufficiente. Per colmare questa lacuna, proponiamo Candidate Set Visual Grounding (CSVG), un compito che consiste nello stimare l’insieme degli oggetti compatibili con il contesto dialogico fornito. Introduciamo inoltre CandVG, un benchmark che valuta come cambia l’insieme dei candidati nei diversi turni del dialogo. La nostra valutazione dei modelli visivo-linguistici mostra che una maggiore capacità di grounding visivo non si traduce necessariamente in prestazioni migliori nel CSVG. In particolare, i modelli faticano a prevedere l’insieme completo dei candidati, a causa delle difficoltà nella generazione dei candidati e della scelta prematura di un insieme ristretto di candidati nei primi turni. Rileviamo tuttavia che, nei modelli su larga scala valutati, questo limite può essere mitigato in parte mediante istruzioni concepite per il CSVG.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv