Ricerca
RealtimeWAM: a che velocità posso eseguire il mio modello del mondo e dell’azione?
I modelli del mondo e dell’azione (World Action Models, WAM) combinano la modellazione delle dinamiche visive con la generazione di azioni, ma l’elevata latenza dell’inferenza limita la reattività del
- arXiv
- 2610.10079
- Pubblicato
- 2026-10-07
- Autori
- Huanan Liu, Ye Li, Kangye Ji, Xiaoyu Chen, Hanyun Cui, Yutian Shen, Yuan Meng, Chenglei Wu, Jingyan Jiang, Bo Li, Zhi Wang
Abstract degli autori
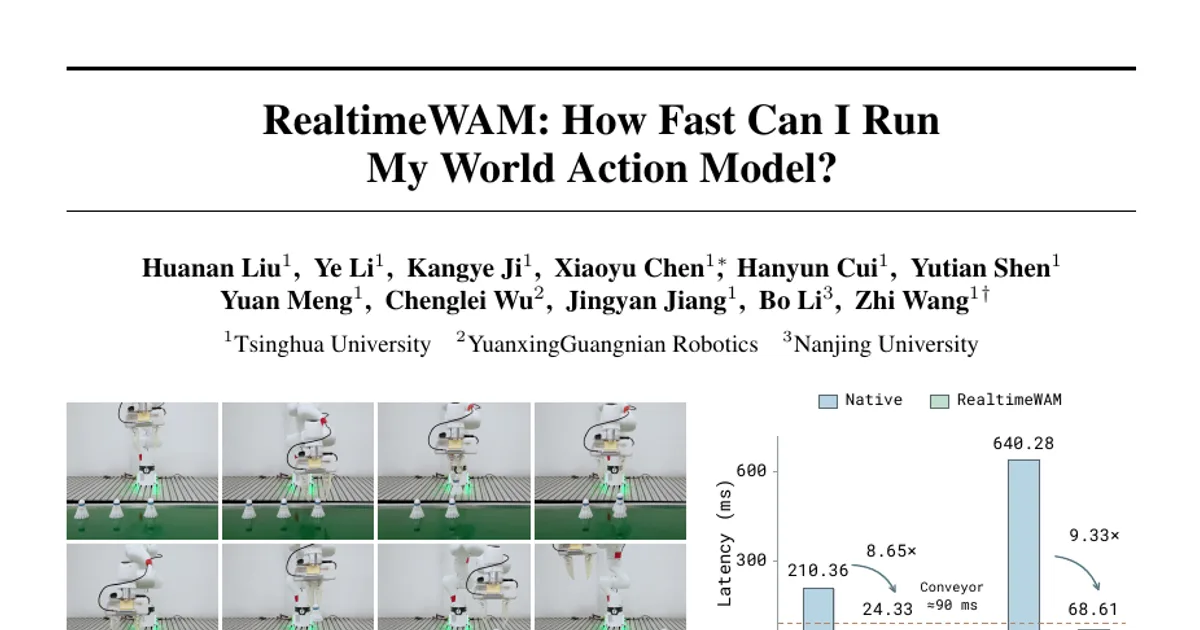
I modelli del mondo e dell’azione (World Action Models, WAM) combinano la modellazione delle dinamiche visive con la generazione di azioni, ma l’elevata latenza dell’inferenza limita la reattività del controllo robotico. Alcuni lavori recenti accelerano l’inferenza eliminando la generazione esplicita di video futuri in fase di test, come in FastWAM, un approccio che richiede un’architettura progettata appositamente. Strategie di caching più generali sfruttano la ridondanza delle caratteristiche, ma la sola ridondanza non tiene conto delle esigenze di calcolo variabili del controllo a ciclo chiuso. Per affrontare queste sfide presentiamo RealtimeWAM, un framework generale che non richiede addestramento e coordina l’esecuzione parallela con un impiego adattivo delle risorse di calcolo, per ridurre la latenza dell’inferenza in diverse architetture WAM. Sfruttiamo le dipendenze tra i livelli per sovrapporre l’elaborazione delle osservazioni alla predizione. I rami eseguiti in parallelo, tuttavia, continuano a contendersi le risorse della GPU, limitando i benefici dell’esecuzione parallela. Adattiamo quindi il calcolo lungo l’intera pipeline mediante un riutilizzo selettivo: memorizziamo nella cache le caratteristiche delle osservazioni nelle regioni visivamente stabili e riutilizziamo i residui dei Transformer, riservando un ulteriore affinamento ai piccoli aggiustamenti previsti. Valutiamo RealtimeWAM su FastWAM e OpenWAM con RoboTwin, LIBERO e LIBERO-Plus. Su una RTX 4090, le latenze medie di inferenza misurate sono di 24,09 e 63,09 ms, corrispondenti ad accelerazioni medie di 8,90$\times$ e 10,67$\times$. I tassi medi di successo sono rispettivamente dell’82,75% e dell’87,41%, con uno scarto di 0,02 e 0,53 punti percentuali rispetto all’inferenza nativa. In cinque attività nel mondo reale, RealtimeWAM aumenta i tassi medi di successo rispetto all’inferenza nativa di 17,2 e 37,2 punti percentuali rispettivamente su FastWAM e OpenWAM.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv