Ricerca
Leggere, analizzare, descrivere: parsing unificato dei documenti con generazione di descrizioni degli elementi visivi
I sistemi per la comprensione dei documenti vengono di norma valutati come componenti separate, attraverso l’analisi del layout, il riconoscimento ottico del testo, la previsione dell’ordine di lettur
- arXiv
- 2610.20335
- Pubblicato
- 2026-10-14
- Autori
- Yuheng Chen, Yufan Chen, Zhuojun Cai, Ruiping Liu, Junwei Zheng, Jiale Wei, Di Wen, Weijia Fan, Kunyu Peng, Jiaming Zhang, Rainer Stiefelhagen
Abstract degli autori
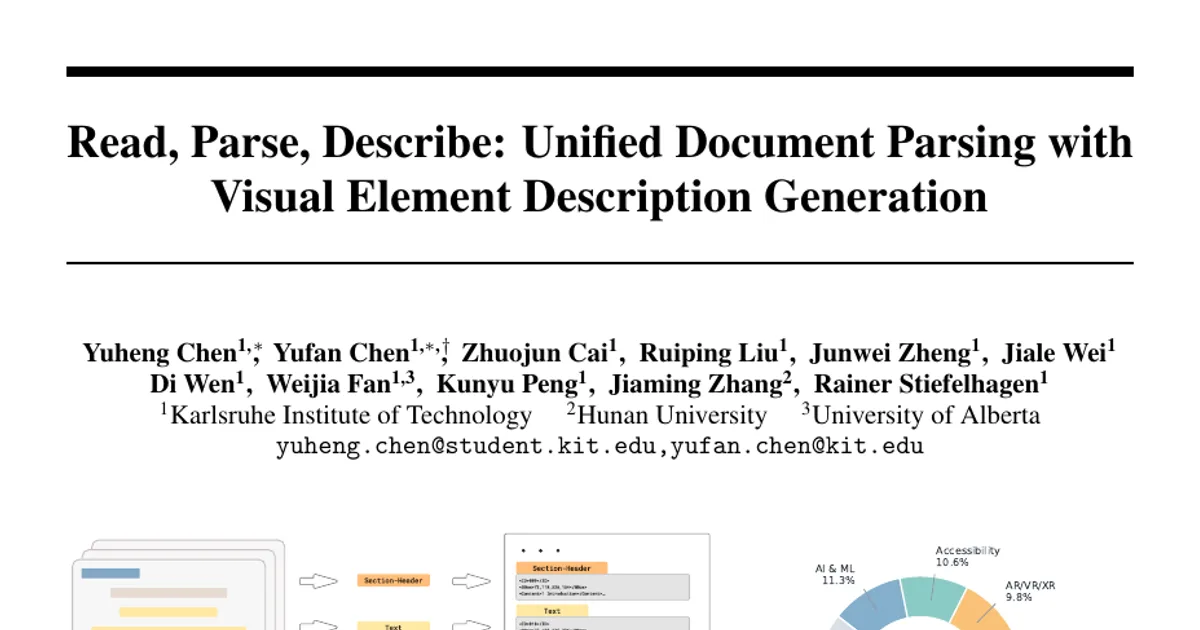
I sistemi per la comprensione dei documenti vengono di norma valutati come componenti separate, attraverso l’analisi del layout, il riconoscimento ottico del testo, la previsione dell’ordine di lettura e la generazione di didascalie per le immagini. Questa separazione lascia debolmente collegate tra loro le figure scientifiche, le didascalie e la semantica visiva, e non misura se un modello sia in grado di produrre un’unica analisi strutturata della pagina che sia al tempo stesso fedele alla sua struttura e semanticamente accessibile. Presentiamo Read-Parse-Describe, un dataset unificato per il parsing dei documenti con generazione di descrizioni degli elementi visivi. Data l’immagine di una pagina, i modelli devono produrre un elenco ordinato di elementi del layout che contenga riquadri di delimitazione, etichette semantiche, indici dell’ordine di lettura, testo riconosciuto e descrizioni testuali alternative degli elementi visivi. Il benchmark è costruito a partire da 2.402 documenti, comprendenti 18.163 pagine consecutive, 125.218 elementi del layout e 11.338 istanze visive. Proponiamo inoltre un modulo plug-and-play che potenzia la consapevolezza spaziale: riutilizza caratteristiche visive estratte da più livelli e introduce nei token visivo-linguistici indicazioni spaziali basate su griglia, per una generazione che tenga conto del layout. Gli esperimenti condotti su VLM end-to-end e sistemi di parsing a pipeline mostrano che i sistemi esistenti hanno ancora difficoltà a ricostruire congiuntamente l’ordine di lettura e la semantica visiva, mentre il nostro modello potenziato ottiene prestazioni congiunte elevate. Questi risultati evidenziano la necessità di superare i moduli isolati di parsing dei documenti e di sviluppare modelli unificati che leggano, analizzino e descrivano congiuntamente documenti complessi. Il nuovo dataset e il codice saranno resi pubblicamente disponibili all’indirizzo https://github.com/yufanchen96/RPD
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv