Ricerca
QK-Edit: ripensare l’iniezione basata sull’attenzione negli MM-DiT per la modifica di immagini e video
I transformer di diffusione multimodali (MM-DiTs) si sono recentemente affermati come un potente approccio alla sintesi unificata di testo e contenuti visivi, superando le tradizionali architetture U-
- arXiv
- 2610.17829
- Pubblicato
- 2026-10-13
- Autori
- Tiancheng Shen, Zilong Huang, Xiangtai Li, Zhijie Lin, Jiyang Liu, Yitong Wang, Jiashi Feng, Ming-Hsuan Yang, Jun Hao Liew
Abstract degli autori
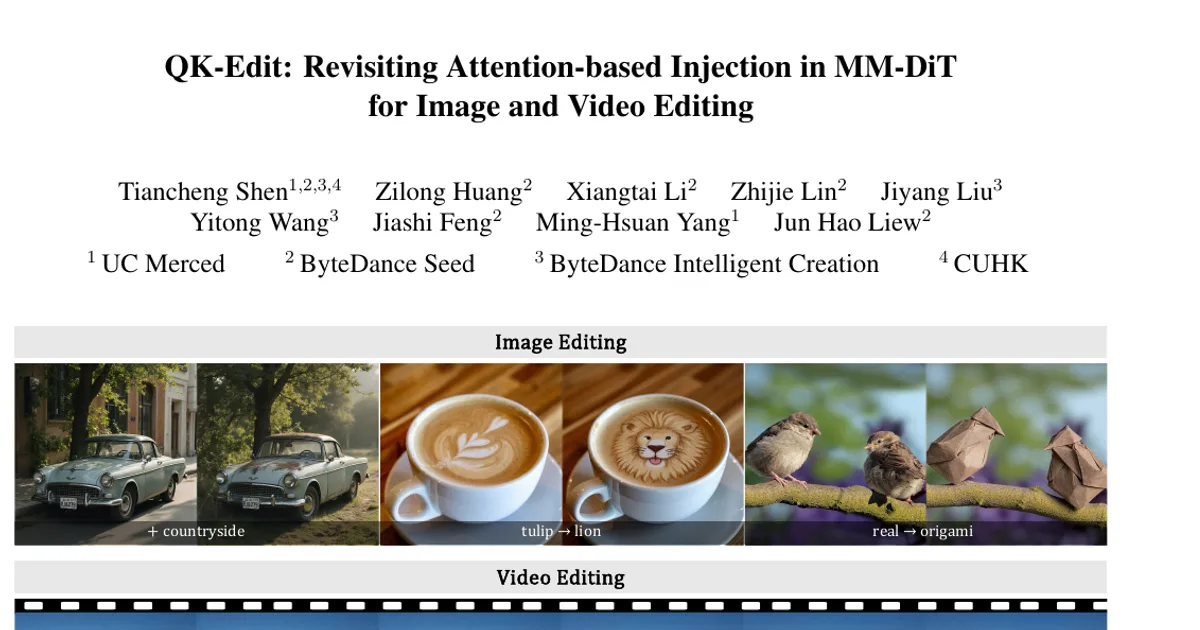
I transformer di diffusione multimodali (MM-DiTs) si sono recentemente affermati come un potente approccio alla sintesi unificata di testo e contenuti visivi, superando le tradizionali architetture U-Net nei compiti generativi. Una delle innovazioni principali è l’interazione di autoattenzione multimodale (Multimodal Self-Attention, MM-SA), in cui i token delle immagini e del testo vengono concatenati ed elaborati tramite autoattenzione. Questo meccanismo, tuttavia, pone notevoli difficoltà per la modifica dei contenuti, rendendo inefficaci i metodi convenzionali di manipolazione dell’attenzione basati su U-Net. Per superare questo limite, proponiamo QK-Edit, un framework che non richiede addestramento e sfrutta le particolari dinamiche dell’attenzione degli MM-DiT per modificare con precisione immagini e video sulla base di istruzioni testuali. Introducendo una nuova strategia di manipolazione di query e key, il nostro metodo isola e regola le componenti cruciali dell’attenzione per raggiungere un equilibrio ottimale tra fedeltà al prompt e coerenza strutturale. Consente così modifiche in vari compiti, tra cui l’aggiunta, la rimozione e la sostituzione di oggetti, il cambiamento dello sfondo, del materiale e del colore e la trasformazione dello stile. Può inoltre essere implementato facilmente tramite la sostituzione delle feature in fase di inferenza. QK-Edit dimostra prestazioni di modifica superiori su modelli all’avanguardia come FLUX e HunyuanVideo, colmando efficacemente il divario tra potenza generativa e flessibilità di modifica negli MM-DiT e aprendo la strada alla creazione scalabile di contenuti multimodali.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv