Ricerca
Principia: test di fisica relazionale per i modelli video
Valutare il ragionamento fisico dei modelli video è difficile perché le misure assolute del movimento dipendono dalla frequenza dei fotogrammi, dalla scala degli oggetti e dalla calibrazione della vid
- arXiv
- 2609.04200
- Pubblicato
- 2026-09-03
- Autori
- Varun Varma Thozhiyoor, Shivam Tripathi, Venkatesh Babu Radhakrishnan, Anand Bhattad
Abstract degli autori
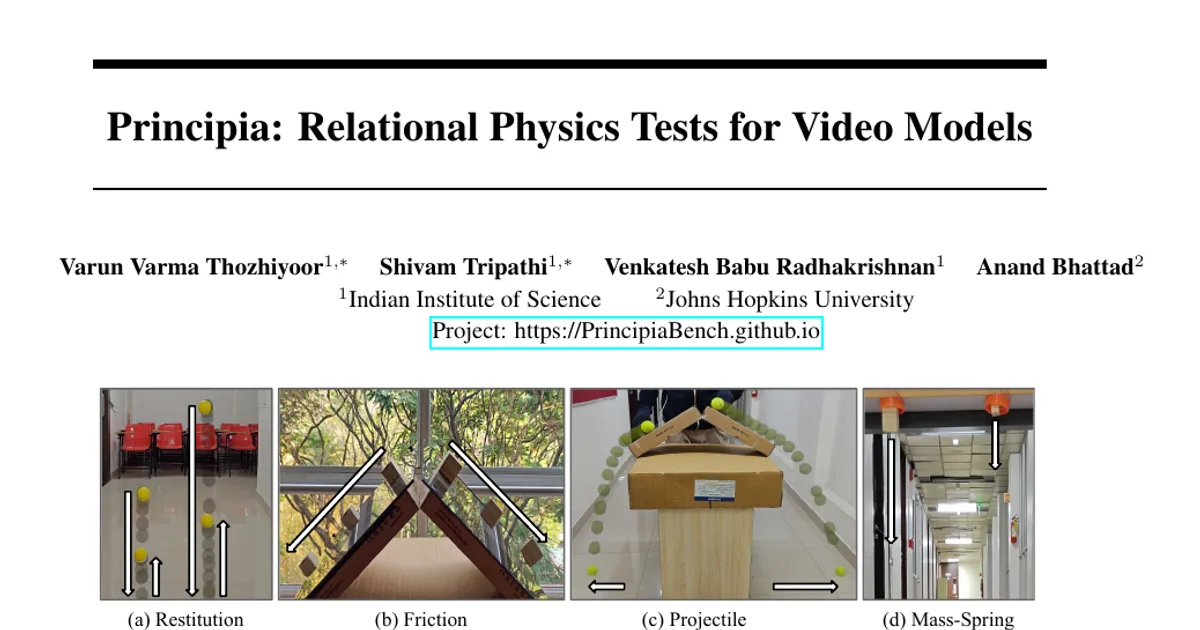
Valutare il ragionamento fisico dei modelli video è difficile perché le misure assolute del movimento dipendono dalla frequenza dei fotogrammi, dalla scala degli oggetti e dalla calibrazione della videocamera, tutti elementi spesso ambigui o non disponibili nei video generati. Proponiamo un approccio diverso. Quando due oggetti nella stessa scena obbediscono alla stessa legge fisica, i loro movimenti devono rispettare relazioni prevedibili, che valgono indipendentemente dalla calibrazione. Presentiamo Principia, un benchmark che valuta la fisica newtoniana attraverso la coerenza delle relazioni tra coppie di oggetti. Principia comprende otto fenomeni — gravità, restituzione, attrito, inerzia rotazionale, moto dei proiettili, quantità di moto, pendolo e oscillazione massa-molla — e copre dinamiche traslazionali, rotazionali, delle collisioni e delle oscillazioni, usando scene del mondo reale registrate secondo protocolli controllati. Presentiamo inoltre un punteggio di coerenza indipendente dalla calibrazione, che quantifica direttamente nello spazio dell’immagine le violazioni delle leggi fisiche. Su migliaia di video generati da sei generatori video all’avanguardia, nessun modello supera 0,42 su Principia, nonostante tutti ottengano punteggi intorno a 0,8 su VBench. Valutiamo anche la capacità dei modelli visivo-linguistici di rilevare violazioni delle relazioni fisiche: il modello migliore raggiunge un’accuratezza di appena il 67%, mentre la maggior parte ottiene risultati vicini a quelli del caso.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv