Ricerca
Post-addestramento dei modelli di frontiera per la generazione di immagini da testo mediante la combinazione di ricompense basate sulle preferenze e su rubriche di valutazione
I recenti modelli per la generazione di immagini da testo hanno raggiunto una qualità visiva notevole, ma migliorarli attraverso il post-addestramento resta difficile, perché nessun singolo segnale di
- arXiv
- 2610.02967
- Pubblicato
- 2026-10-02
- Autori
- Yuanhao Ban, I-Hung Hsu, Anastasios Angelopoulos, Wei-Lin Chiang, Ion Stoica, Cho-Jui Hsieh
Abstract degli autori
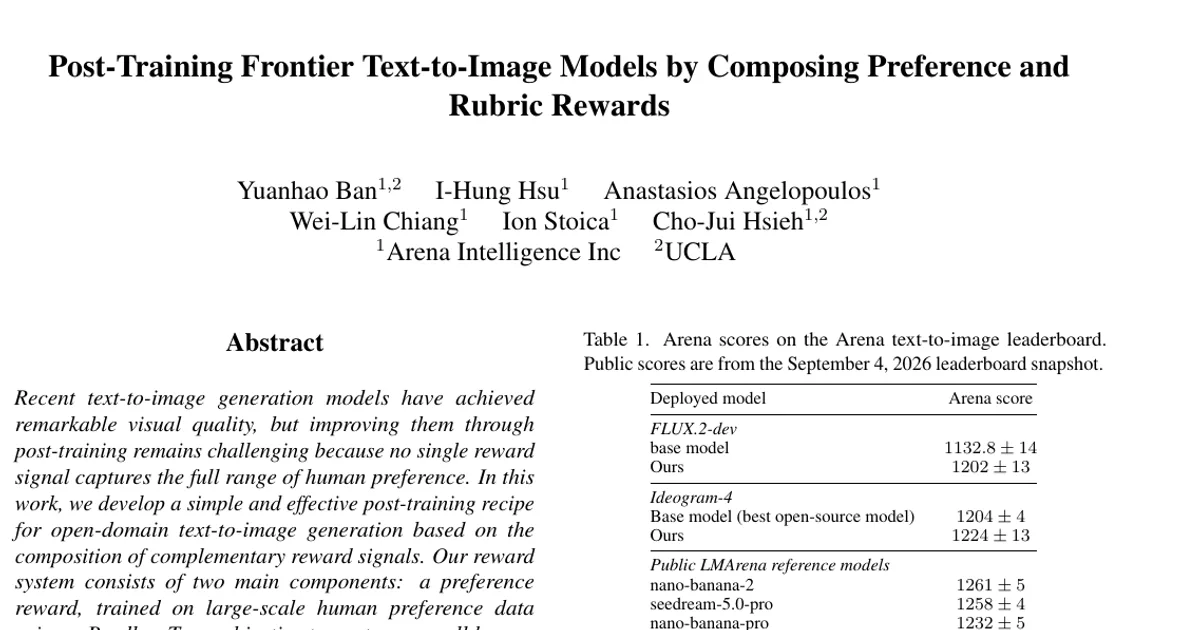
I recenti modelli per la generazione di immagini da testo hanno raggiunto una qualità visiva notevole, ma migliorarli attraverso il post-addestramento resta difficile, perché nessun singolo segnale di ricompensa coglie l’intera gamma delle preferenze umane. In questo lavoro sviluppiamo un metodo di post-addestramento semplice ed efficace per la generazione di immagini da testo in ambito aperto, basato sulla combinazione di segnali di ricompensa complementari. Il nostro sistema di ricompense ha due componenti principali: una ricompensa basata sulle preferenze, addestrata su dati su larga scala relativi alle preferenze umane mediante un obiettivo di Bradley-Terry per cogliere le preferenze estetiche e percettive complessive delle persone, e ricompense basate su rubriche di valutazione, che valutano esplicitamente la fedeltà al prompt e altre proprietà desiderabili, offrendo al contempo protezioni contro la manipolazione della ricompensa. Una difficoltà cruciale è combinare questi segnali di ricompensa eterogenei. Mostriamo che una semplice media ponderata porta a un comportamento subottimale nell’ottimizzazione e proponiamo una strategia semplice di combinazione delle ricompense che bilancia più efficacemente l’ottimizzazione delle preferenze e il rispetto dei criteri delle rubriche. Nella classifica di Arena per la generazione di immagini da testo (https://arena.ai/), il nostro Flux2dev addestrato con apprendimento per rinforzo ottiene un punteggio Elo superiore di 69 punti a quello del modello di base, mentre il nostro Ideogram-4 sottoposto a post-addestramento supera tutti i modelli open source presenti in classifica, raggiungendo un punteggio Elo di 1223,5. (Le affermazioni sulle prestazioni allo stato dell’arte si basano sulla classifica di Arena rilevata al 4 settembre 2026.) I nostri risultati suggeriscono che ricompense efficaci per l’addestramento di modelli generativi di frontiera richiedono un’ampia copertura degli intenti degli utenti e resistenza allo sfruttamento durante l’ottimizzazione. Per favorire la ricerca riproducibile, rendiamo disponibile Arena-T2I-Training, un sottoinsieme di 1K dati di addestramento che recupera parte dei miglioramenti ottenuti con l’addestramento su scala completa: una risorsa che speriamo faciliti il lavoro futuro sul post-addestramento dei modelli per la generazione di immagini da testo.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv