Ricerca
PanoVLN: verso una navigazione panoramica efficace basata su visione e linguaggio
I recenti modelli di visione e linguaggio (VLM) hanno fatto progredire la navigazione basata su visione e linguaggio (VLN), consentendo ai modelli di prevedere le azioni di navigazione a partire da os
- arXiv
- 2609.34759
- Pubblicato
- 2026-09-28
- Autori
- Zhen Wang, Changpeng Wang, Zhe Liu, Zhangyang Qi, Yuxiang Lu, Zimo Zeng, Donglian Qi, Xi Chen
Abstract degli autori
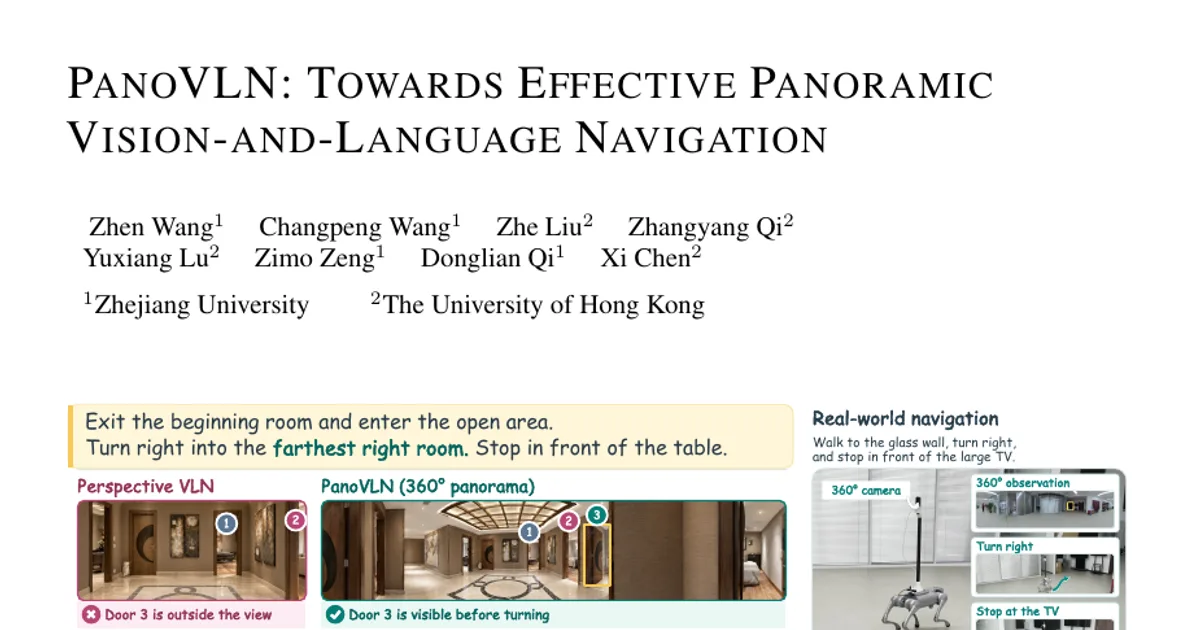
I recenti modelli di visione e linguaggio (VLM) hanno fatto progredire la navigazione basata su visione e linguaggio (VLN), consentendo ai modelli di prevedere le azioni di navigazione a partire da osservazioni visive e istruzioni linguistiche. In questo lavoro esploriamo la VLN con osservazioni panoramiche e presentiamo PanoVLN. L’idea di fondo è semplice: un contesto visivo più completo dovrebbe permettere di prendere decisioni di navigazione più informate. Per esempio, un panorama può mostrare un passaggio fuori dal campo visivo di una fotocamera prospettica, consentendo al modello di individuare il percorso previsto senza ulteriori esplorazioni. Tuttavia, osserviamo che sostituire semplicemente le immagini prospettiche con panorami produce solo miglioramenti limitati. La nostra analisi suggerisce che, per sfruttare appieno la maggiore visibilità, occorrono modifiche alla previsione delle azioni, alla supervisione durante l’addestramento e alla rappresentazione visiva. In primo luogo, la maggiore visibilità permette di pianificare le azioni su un orizzonte più lungo. Facciamo prevedere al modello sequenze di azioni più lunghe, rendendo possibili rotazioni più ampie e successivi spostamenti a partire da un solo panorama. Nello specifico, introduciamo una strategia di esecuzione guidata dalla confidenza (CGE) che determina dinamicamente quante delle azioni previste eseguire prima di ripianificare. In secondo luogo, la maggiore visibilità comporta anche scelte di percorso più complesse. Costruiamo quindi percorsi di addestramento con bivi frequenti e istruzioni chiare, per fornire una supervisione mirata alla scelta del percorso. In terzo luogo, la navigazione panoramica richiede di comprendere le relazioni spaziali tra diverse direzioni di osservazione, oltre a riconoscere i singoli punti di riferimento. Combiniamo caratteristiche semantiche e geometriche ricavate da panorami RGB per rappresentare sia il contenuto della scena sia la disposizione spaziale, senza aggiungere token visivi. Con un backbone da 4B e un input esclusivamente RGB, PanoVLN supera il precedente stato dell’arte di 11,9% e 8,7% nel tasso di successo su R2R-CE e RxR-CE Val-Unseen. Esperimenti nel mondo reale condotti su un quadrupede mostrano inoltre una navigazione più rapida e con meno pause rispetto ai precedenti metodi VLN.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv