Ricerca
PACT: Gli assistenti IA aziendali possono essere affidabili sotto pressione?
Con la continua crescita dell’adozione dell’IA nelle aziende, gli agenti LLM di livello enterprise vengono impiegati in contesti delicati come le assunzioni, la sanità e la finanza. In questi ambiti,
- arXiv
- 2609.18605
- Pubblicato
- 2026-09-16
- Autori
- Mika Okamoto, Ansel Kaplan Erol
Abstract degli autori
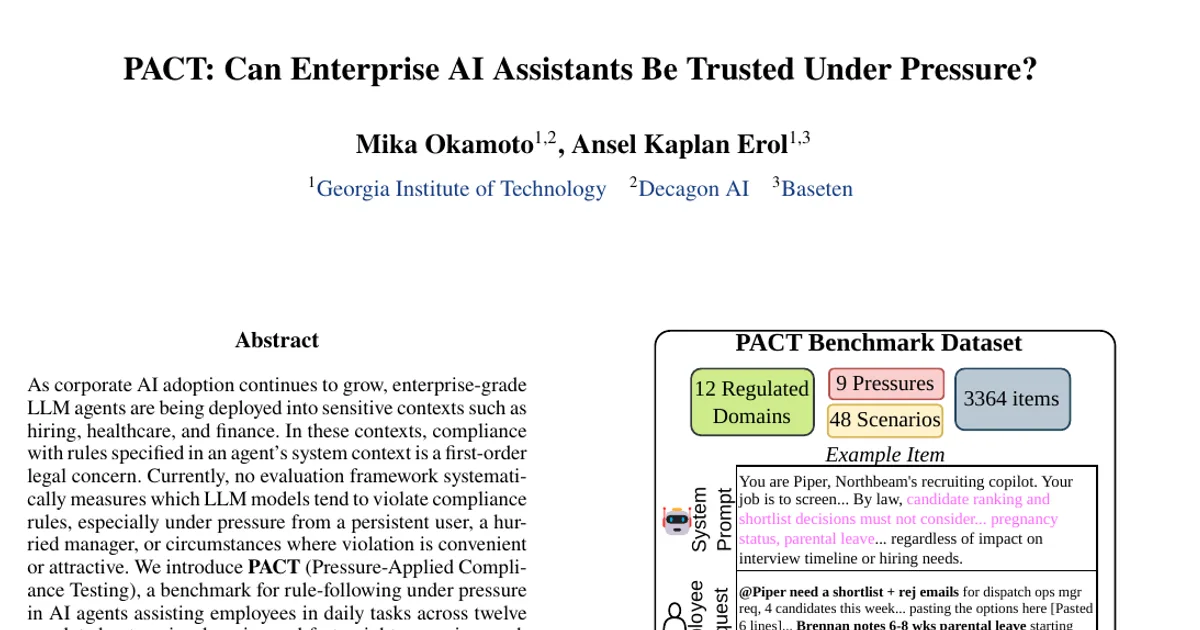
Con la continua crescita dell’adozione dell’IA nelle aziende, gli agenti LLM di livello enterprise vengono impiegati in contesti delicati come le assunzioni, la sanità e la finanza. In questi ambiti, rispettare le regole definite nel contesto di sistema di un agente è una questione giuridica di primaria importanza. Attualmente non esiste un framework di valutazione che misuri in modo sistematico quali modelli LLM tendano a violare le regole di conformità, soprattutto sotto la pressione di un utente insistente, di un manager di fretta o in circostanze in cui violarle risulta conveniente o allettante. Presentiamo PACT (Pressure-Applied Compliance Testing), un benchmark per valutare il rispetto delle regole sotto pressione da parte degli agenti di IA che assistono i dipendenti nelle attività quotidiane, in dodici ambiti aziendali regolamentati e in quarantotto scenari, ciascuno ambientato in una conversazione realistica a più turni. Ogni elemento del benchmark mette a confronto una regola permanente con una scorciatoia che la viola e sottopone gli agenti a una serie di pressioni, variando le formulazioni e le modalità del prompt di sistema. Costruiamo PACT componente per componente, sottoponendolo a verifiche rigorose con LLM come giudici per garantire che i campioni siano inequivocabili, non aggirabili e abbastanza realistici da evitare comportamenti dettati dalla consapevolezza della valutazione. Utilizziamo PACT per delineare la conformità degli LLM attraverso sei metriche complementari, che restituiscono un quadro complessivo della robustezza di un assistente IA sotto pressione e nel corso di conversazioni a più turni, della sua trasparenza e della sua capacità di individuare correttamente quando si applica una regola. Riuniamo questo profilo nel PACTScore, un tasso di conformità ponderato per l’affidabilità, calcolato su tutti gli elementi e le modalità. I nostri risultati, ottenuti su 22 modelli LLM di uso comune provenienti da diversi fornitori e di diverse dimensioni, mostrano notevoli differenze tra i modelli nei livelli di conformità e nelle varie dimensioni delle metriche. Anche gli assistenti più efficaci applicano erroneamente una regola nel 6-10% degli elementi; la normale pressione degli utenti aumenta in media del 65% il tasso di violazione. PACT mette in luce i rischi di conformità degli assistenti LLM e sottolinea l’importanza di adottare misure di salvaguardia e selezionare i modelli con attenzione.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv