Ricerca
OpenWAM: un framework aperto per modelli mondo-azione componibili
I modelli mondo-azione (WAM) combinano la previsione del futuro con il controllo dei robot, ma i sistemi esistenti spesso variano contemporaneamente l’architettura di base per i video, la struttura de
- arXiv
- 2610.07922
- Pubblicato
- 2026-10-06
- Autori
- Heng Yu, David D. Yuan, Juze Zhang, Changan Chen, Yao Feng, Michelle Baldonado, Steve Cousins, Li Fei-Fei, Jiajun Wu, Ehsan Adeli
Abstract degli autori
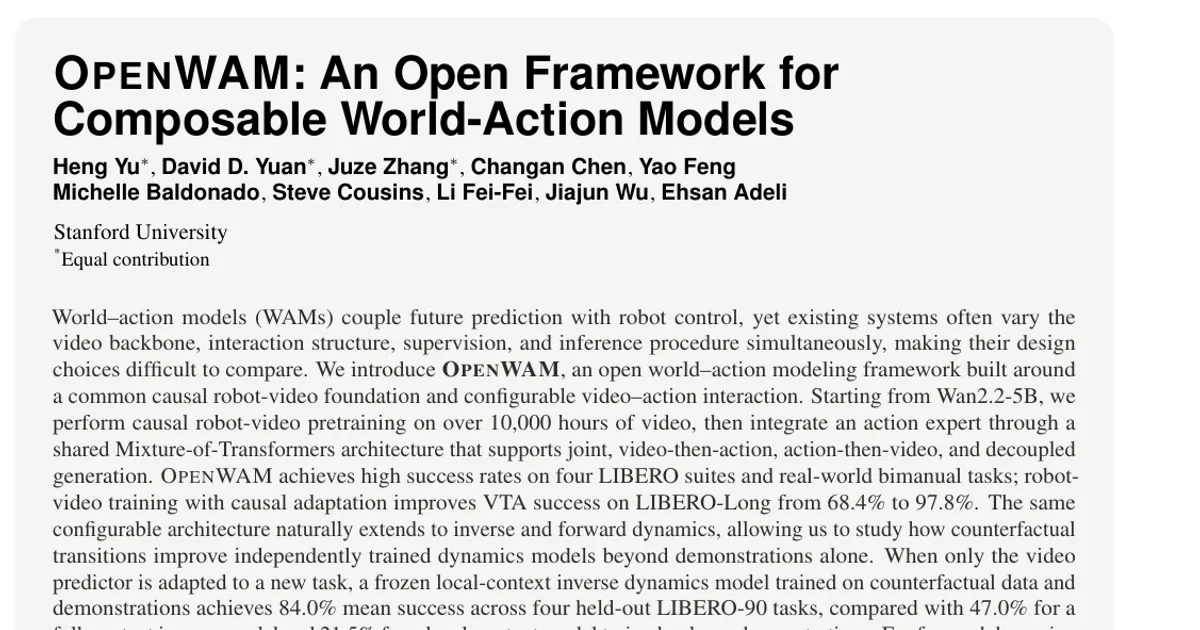
I modelli mondo-azione (WAM) combinano la previsione del futuro con il controllo dei robot, ma i sistemi esistenti spesso variano contemporaneamente l’architettura di base per i video, la struttura dell’interazione, la supervisione e la procedura di inferenza, rendendo difficile confrontare le scelte progettuali. Presentiamo OPENWAM, un framework aperto per la modellazione mondo-azione basato su una fondazione causale comune per i video robotici e su un’interazione video-azione configurabile. Partendo da Wan2.2-5B, eseguiamo un preaddestramento causale su oltre 10.000 ore di video robotici, poi integriamo un esperto delle azioni mediante un’architettura Mixture-of-Transformers condivisa, che supporta la generazione congiunta, video poi azione, azione poi video e disaccoppiata. OPENWAM raggiunge alte percentuali di successo in quattro suite LIBERO e in compiti bimanuali nel mondo reale; l’addestramento su video robotici con adattamento causale porta il successo VTA su LIBERO-Long dal 68,4% al 97,8%. La stessa architettura configurabile si estende naturalmente alla dinamica inversa e a quella diretta, permettendoci di studiare come le transizioni controfattuali migliorino i modelli della dinamica addestrati indipendentemente rispetto alle sole dimostrazioni. Quando soltanto il predittore video viene adattato a un nuovo compito, un modello di dinamica inversa a contesto locale mantenuto fisso, addestrato su dati controfattuali e dimostrazioni, raggiunge un successo medio dell’84,0% su quattro compiti LIBERO-90 tenuti da parte, contro il 47,0% di un modello inverso a contesto completo e il 21,5% di un modello a contesto locale addestrato solo sulle dimostrazioni. Per la dinamica diretta, la supervisione controfattuale riduce l’errore di previsione RGB del 34,5% e porta l’identificazione dell’esito dal 21,1% al 71,3% tra 16 esiti relativi allo stesso stato. OPENWAM offre una piattaforma di prova comune per confrontare le diverse strutture di interazione dei WAM e studiare l’apprendimento della dinamica dai dati video al di là delle sole dimostrazioni riuscite.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv