Ricerca
onPanda: annotazione efficiente di dati di allineamento on-policy per LLM e agenti tramite correzione a livello di token
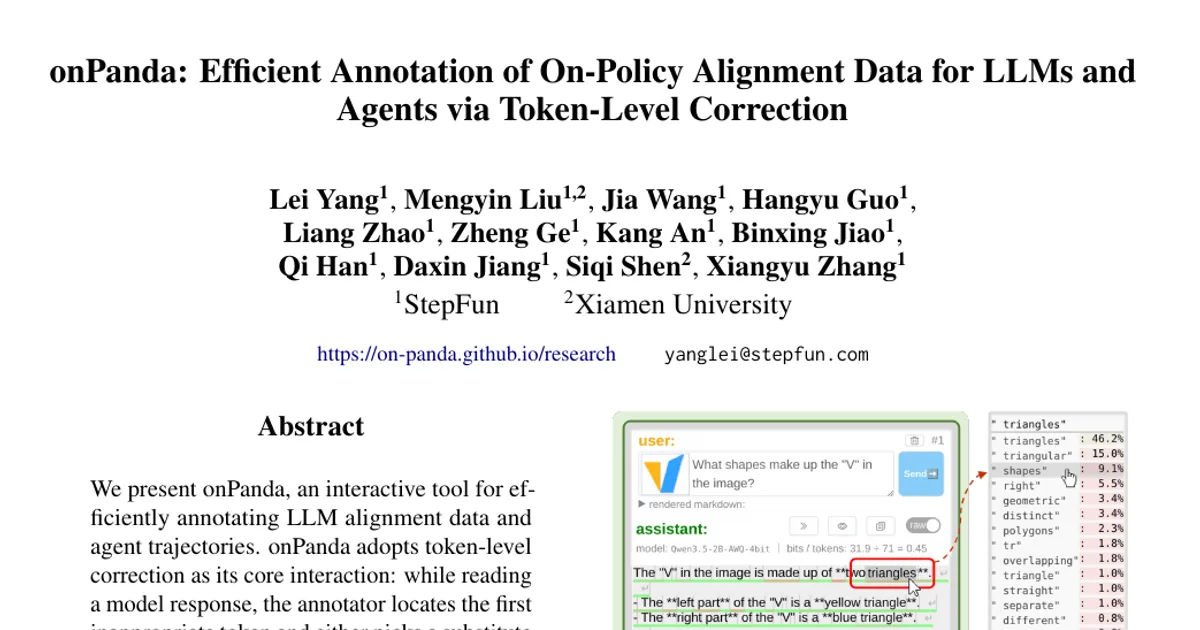
Presentiamo onPanda, uno strumento interattivo per annotare in modo efficiente dati di allineamento per LLM e traiettorie di agenti. onPanda adotta la correzione a livello di token come modalità d’int
- arXiv
- 2609.24983
- Pubblicato
- 2026-09-21
- Autori
- Lei Yang, Mengyin Liu, Jia Wang, Hangyu Guo, Liang Zhao, Zheng Ge, Kang An, Binxing Jiao, Qi Han, Daxin Jiang, Siqi Shen, Xiangyu Zhang
Abstract degli autori
Presentiamo onPanda, uno strumento interattivo per annotare in modo efficiente dati di allineamento per LLM e traiettorie di agenti. onPanda adotta la correzione a livello di token come modalità d’interazione principale: mentre legge una risposta del modello, l’annotatore individua il primo token inappropriato e sceglie un sostituto tra i token candidati del modello oppure digita il testo corretto con una modifica libera. Il sistema tronca quindi tutto ciò che segue quella posizione e riprende la generazione dal prefisso corretto, ripetendo questo ciclo di individuazione, correzione e continuazione fino a ottenere una risposta soddisfacente. Questo meccanismo consente agli annotatori di guidare con precisione le risposte del modello a basso costo: un piccolo studio controllato suggerisce che onPanda riduce del 52% il tempo mediano di annotazione rispetto alla post-modifica manuale. Poiché la stragrande maggioranza dei token della risposta finale è generata dal modello stesso, i dati risultanti preservano in larga misura la distribuzione di campionamento del modello e sono adatti alla creazione di dati SFT on-policy e di preferenza. Inoltre, le correzioni a livello di token registrate durante l’annotazione forniscono una supervisione dettagliata, con posizioni precise e campioni positivi e negativi abbinati in modo naturale. onPanda si collega anche a strumenti esterni e ambienti di esecuzione, consentendo l’annotazione interattiva di traiettorie in ambienti realistici. Rilasciamo inoltre Panda-CVL, un dataset annotato con onPanda, insieme a un benchmark per la correzione a livello di token.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv