Ricerca
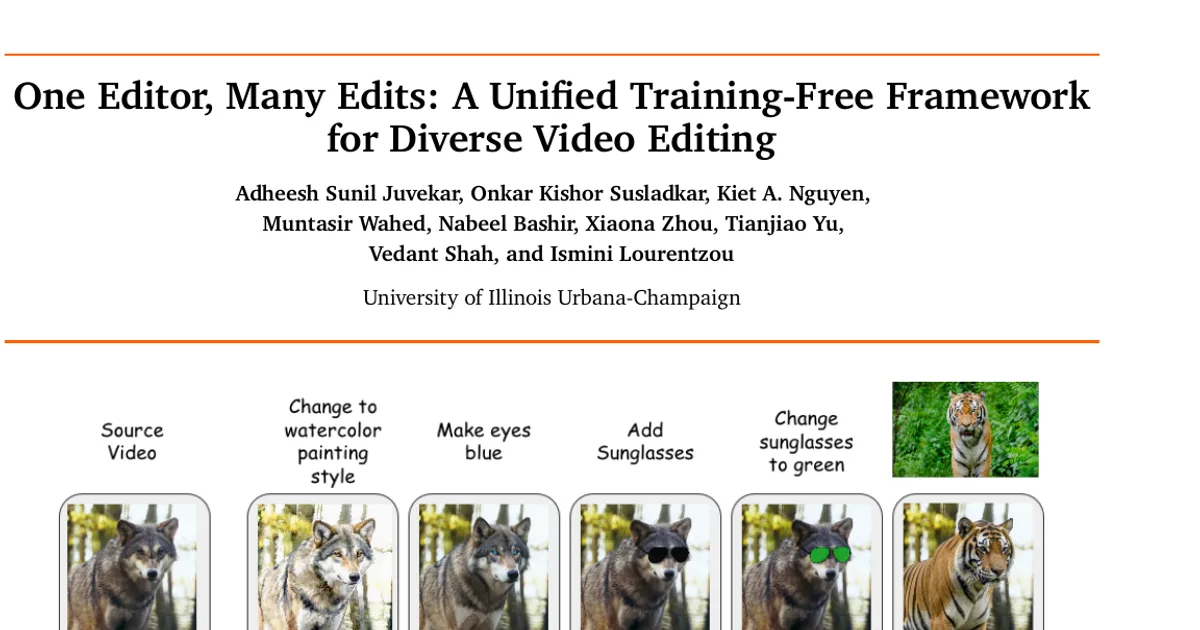
Un editor, molte modifiche: un framework unificato senza addestramento per diverse forme di editing video
L’editing video comprende modalità diverse, ma ottenere modifiche di alta qualità guidate da istruzioni e da un soggetto all’interno di un unico framework resta difficile. Presentiamo EditVid, un fram
- arXiv
- 2609.04190
- Pubblicato
- 2026-09-03
- Autori
- Adheesh Sunil Juvekar, Onkar Kishor Susladkar, Kiet A. Nguyen, Muntasir Wahed, Nabeel Bashir, Xiaona Zhou, Tianjiao Yu, Vedant Shah, Ismini Lourentzou
Abstract degli autori
L’editing video comprende modalità diverse, ma ottenere modifiche di alta qualità guidate da istruzioni e da un soggetto all’interno di un unico framework resta difficile. Presentiamo EditVid, un framework senza addestramento che combina una memoria causale sparsa per la coerenza locale, l’iniezione di token basata sulle corrispondenze dopo l’attenzione per preservare l’identità a lungo raggio e una fusione morbida nello spazio latente per mantenere localizzate le modifiche. Lo stesso framework supporta modifiche guidate da istruzioni e da riferimenti, tra cui il trasferimento di stile, la modifica degli attributi, l’inserimento di oggetti, la modifica di singole parti e la sostituzione del soggetto. Su FiVE, EditVid ottiene un punteggio FiVE-Acc di 78,16, rispetto a 58,95 del migliore metodo di riferimento senza addestramento tra quelli valutati, e consegue risultati competitivi su IVEBench. Uno studio condotto sugli utenti mostra inoltre una preferenza complessiva del 51,8\% per EditVid rispetto a 7 metodi concorrenti.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv