Ricerca
Sulla punta della lingua: il First-Token Cueing come sonda comportamentale delle difficoltà di richiamo nei modelli linguistici di grandi dimensioni
I modelli linguistici di grandi dimensioni rispondono spesso in modo errato alle domande fattuali quando non possono consultare fonti esterne, e questi errori vengono di solito attribuiti alla mancanz
- arXiv
- 2610.23400
- Pubblicato
- 2026-10-16
- Autori
- Jaewon Sok, Jewon Yeom, Seonghyeon Park, Jeongjae Park, Hwiyeong Lee, Taesup Kim
Abstract degli autori
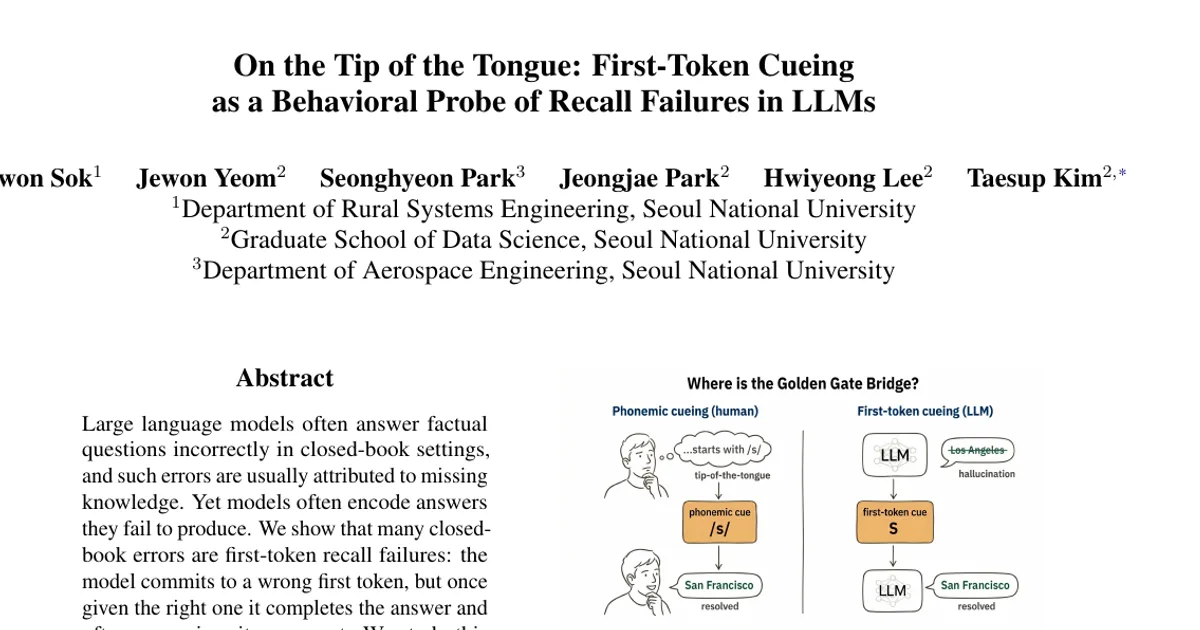
I modelli linguistici di grandi dimensioni rispondono spesso in modo errato alle domande fattuali quando non possono consultare fonti esterne, e questi errori vengono di solito attribuiti alla mancanza delle conoscenze necessarie. Eppure i modelli spesso codificano risposte che non riescono a produrre. Mostriamo che molti errori in queste condizioni sono dovuti a un mancato richiamo del primo token: il modello sceglie un primo token errato, ma, se gli viene fornito quello giusto, completa la risposta e spesso riconosce che è corretta. Studiamo il fenomeno con il First-Token Cueing, una sonda comportamentale che inserisce all’inizio della risposta il primo token della risposta corretta di riferimento. L’incertezza del modello raggiunge il picco al primo token della risposta, dove il modello è già in grado di prevedere se la risposta sarà corretta; tra i prefissi della risposta corretta di riferimento di qualsiasi lunghezza, il solo primo token consente di recuperare la quota maggiore di errori. Su 16 modelli aperti, questo singolo token corregge da un quinto alla metà degli errori nelle risposte composte da più token nei test di domande e risposte in inglese e migliora l’accuratezza in tutte le sette lingue di un benchmark multilingue. La maggior parte degli errori che corregge viene risolta anche dal ragionamento generato per campionamento dal modello stesso, un criterio per stabilire che la conoscenza è codificata nel modello. Inoltre, i modelli riconoscono inizi corretti che non producono: proseguono un inizio corretto con maggiore sicurezza rispetto a uno errato dello stesso tipo di risposta e con la stessa probabilità a priori, eppure raramente lo individuano senza la risposta corretta di riferimento. Questi risultati individuano una classe di errori fattuali recuperabili nel primo passaggio di decodifica, dove i metodi applicati in fase di inferenza potrebbero ottenere i maggiori benefici.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv