Ricerca
Omni-Embed-Mini: unire le modalità senza dimenticare grazie alla distillazione densa
Estendere un modello di embedding testuale a nuove modalità comporta in genere un peggioramento della qualità del recupero dei testi, e i modelli di embedding omnimodali esistenti compensano con milia
- arXiv
- 2610.02148
- Pubblicato
- 2026-10-01
- Autori
- Mohammed Irfan Kurpath, Jaseel Muhammad Kaithakkodan, Sahal Shaji Mullappilly, Ivan Laptev, Hisham Cholakkal
Abstract degli autori
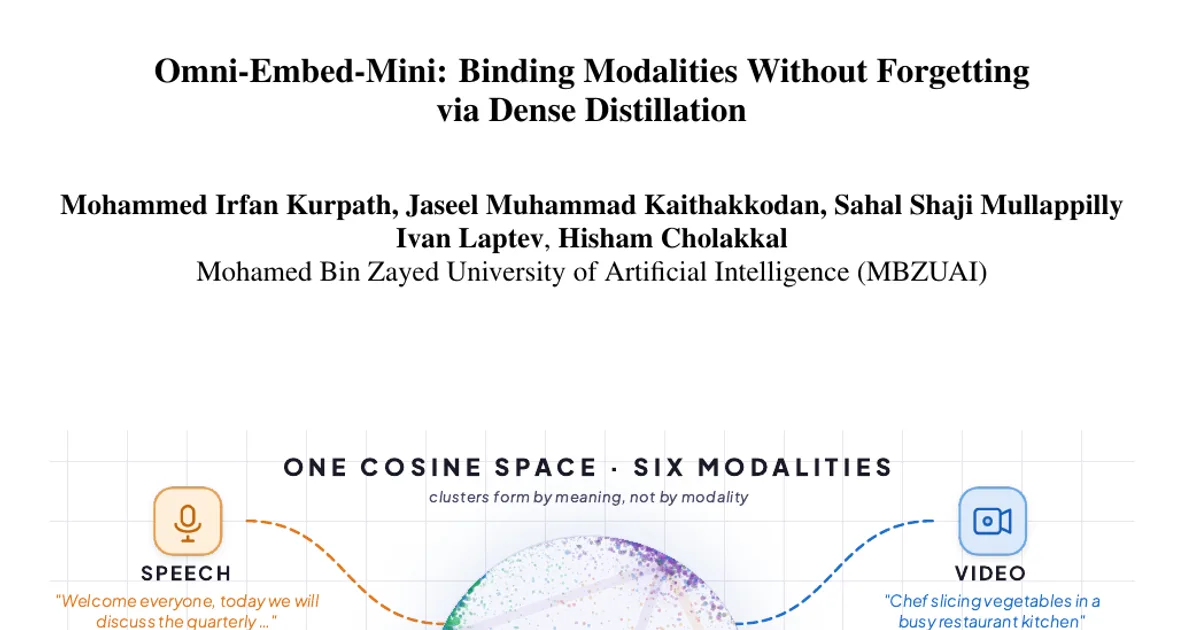
Estendere un modello di embedding testuale a nuove modalità comporta in genere un peggioramento della qualità del recupero dei testi, e i modelli di embedding omnimodali esistenti compensano con miliardi di parametri. Presentiamo Omni-Embed-Mini, un modello da 0,9 miliardi di parametri che colloca testo, parlato, audio, immagini, video e documenti ricchi di elementi visivi in un unico spazio coseno condiviso, senza aggiornare alcun parametro della componente testuale. L’intuizione centrale è che il segnale del modello insegnante non richiede un modello di embedding separato: ogni campione multimediale è associato a una didascalia densa a cascata, e il target dell’insegnante è semplicemente l’embedding di quella didascalia prodotto dal backbone congelato. Poiché insegnante e studente condividono gli stessi pesi del backbone, operano in una geometria identica byte per byte; per l’allineamento bastano quindi proiettori leggeri e adattatori LoRA introdotti per fasi negli encoder delle modalità. L’addestramento combina una funzione di perdita contrastiva Matryoshka SigLIP con un sistema ibrido online di selezione degli esempi negativi difficili, che diventano più mirati man mano che l’encoder migliora. Lo stesso metodo si applica a una variante da 2,3 miliardi di parametri sostituendo il backbone con uno visivo-linguistico nativo. Omni-Embed-Mini-0.9B mantiene i pesi della componente testuale identici bit per bit a quelli del backbone, perciò l’addestramento non può peggiorare il recupero dei testi (49,57 nDCG@10 su MTEB-v2 BEIR-8), pur estendendo il modello a cinque modalità aggiuntive. È inoltre da circa 2,7 a 9,5 volte più piccolo di ciascun modello di embedding omnimodale aperto con cui lo confrontiamo. La variante da 2,3 miliardi di parametri è competitiva rispetto al modello chiuso gemini-embedding-2 e lo supera di poco nella media complessiva tra le modalità. Modelli, codice, dati e strumenti di valutazione sono disponibili sulla pagina del progetto: https://omniembed.cvmbzuai.com
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv