Ricerca
Obiettivo vs. ricerca: scomporre ciò che rende valido un tokenizzatore
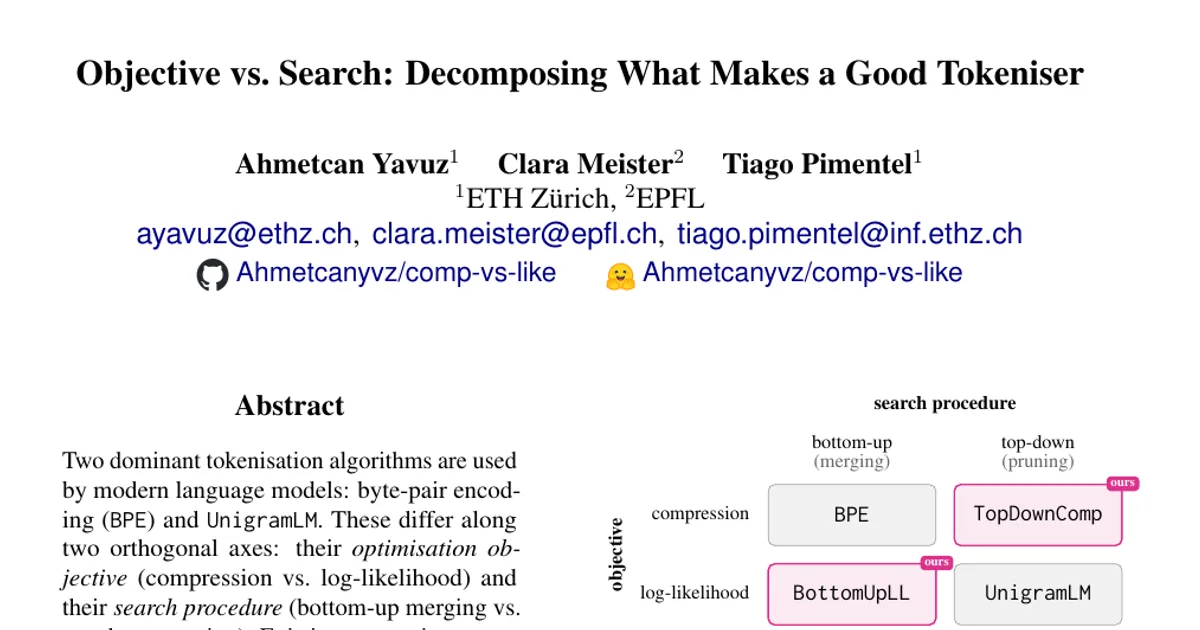
I modelli linguistici moderni utilizzano due algoritmi di tokenizzazione dominanti: byte-pair encoding (BPE) e UnigramLM. Si distinguono lungo due assi ortogonali: l’obiettivo di ottimizzazione (compr
- arXiv
- 2609.19145
- Pubblicato
- 2026-09-16
- Autori
- Ahmetcan Yavuz, Clara Meister, Tiago Pimentel
Abstract degli autori
I modelli linguistici moderni utilizzano due algoritmi di tokenizzazione dominanti: byte-pair encoding (BPE) e UnigramLM. Si distinguono lungo due assi ortogonali: l’obiettivo di ottimizzazione (compressione vs. log-verosimiglianza) e la procedura di ricerca (unione dal basso verso l’alto vs. potatura dall’alto verso il basso). I confronti esistenti confondono questi due assi, rendendo poco chiaro se le differenze osservate derivino da ciò che viene ottimizzato o da come viene ottimizzato. Separiamo i due aspetti introducendo due nuovi algoritmi di tokenizzazione che completano questo spazio di progettazione 2x2: BottomUpLL, un tokenizzatore basato sulla verosimiglianza che procede dal basso verso l’alto, e TopDownComp, un tokenizzatore basato sulla compressione che procede dall’alto verso il basso. Addestriamo modelli linguistici con tokenizzatori prodotti da ciascun algoritmo, variando le dimensioni dei modelli, quelle dei vocabolari e il dominio (solo inglese vs. multilingue). Valutando i modelli in base ai bit per byte, scopriamo che il fattore dominante è la procedura di ricerca, non l’obiettivo: nella maggior parte delle configurazioni, i tokenizzatori che procedono dal basso verso l’alto ottengono sistematicamente valori più bassi di bit per byte. La valutazione dei modelli sul compito BLiMP, tuttavia, non mostra una relazione costante tra le scelte progettuali e le prestazioni. Nel complesso, i nostri risultati isolano l’effetto delle scelte di progettazione dei tokenizzatori sulle prestazioni nella modellazione linguistica, offrendo indicazioni concrete per costruirli in modo più rigoroso.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv