Ricerca
MultiVENT-Raw: un benchmark per il recupero e il ragionamento su video grezzi
Le informazioni online vengono sempre più spesso fruite in formato video. Gran parte di questi contenuti è costituita da video grezzi: riprese continue effettuate con un cellulare, una videocamera por
- arXiv
- 2609.28437
- Pubblicato
- 2026-09-23
- Autori
- Reno Kriz, David Etter, Alexander Martin, Cameron Carpenter, Debashish Chakraborty, Hannah Recknor, Reihaneh Iranmanesh, Matthew Maciejewski, Kenton Murray, Eugene Yang, Benjamin Van Durme, Aaron Steven White, Andrew Yates, William Walden
Abstract degli autori
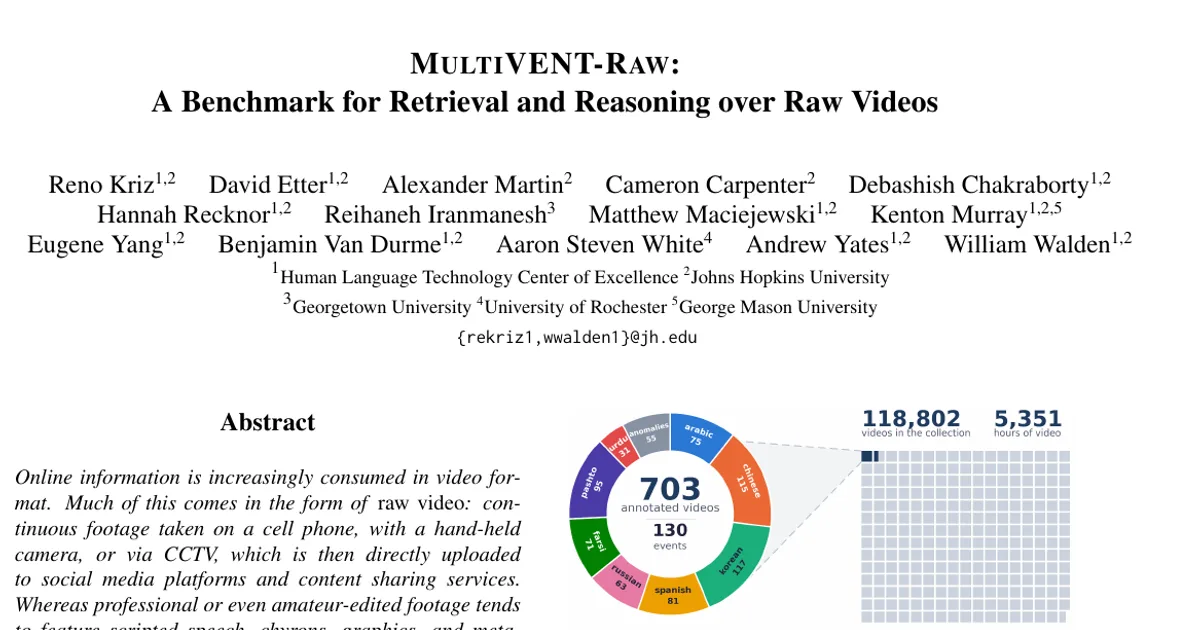
Le informazioni online vengono sempre più spesso fruite in formato video. Gran parte di questi contenuti è costituita da *video grezzi*: riprese continue effettuate con un cellulare, una videocamera portatile o tramite sistemi di videosorveglianza, poi caricate direttamente sulle piattaforme social e sui servizi di condivisione di contenuti. Mentre le riprese professionali o anche quelle amatoriali montate tendono a includere discorsi preparati, sottopancia, elementi grafici e metadati che aiutano a contestualizzarne il contenuto, i video grezzi in genere non presentano nulla di tutto ciò, il che li rende un mezzo molto più difficile per il recupero delle informazioni e la comprensione da parte delle macchine. Per favorire i progressi in questo ambito, presentiamo MultiVENT-Raw, una raccolta multilingue di quasi 120.000 video perlopiù grezzi (oltre 5.300 ore complessive), associati a 130 eventi e 222 query incentrate sugli eventi, insieme a valutazioni della pertinenza dei video annotate da esseri umani e a fatti chiave estratti da esseri umani per i video pertinenti. MultiVENT-Raw supporta sia un’attività di recupero — per individuare nella raccolta i video pertinenti a un evento specificato in una query — sia un’attività di generazione — per riassumere i video relativi a un evento in un resoconto coerente destinato a un utente. Valutiamo i principali modelli di riferimento su MultiVENT-Raw e mostriamo che entrambe le attività sono complesse, anche per alcuni dei più recenti modelli multimodali.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv