Ricerca
MoSE3: apprendere SE(3) nello spazio del mondo a ogni pixel
Il tracciamento denso di punti 3D è un paradigma importante per modellare il movimento nelle scene dinamiche. Tuttavia, la traiettoria di un punto è soltanto una curva di traslazione a 3 gradi di libe
- arXiv
- 2610.03716
- Pubblicato
- 2026-10-02
- Autori
- Jiahuan Cheng, Zhiyi Li, Tian Xia, Ruojin Cai, Yilun Du, Qianqian Wang
Abstract degli autori
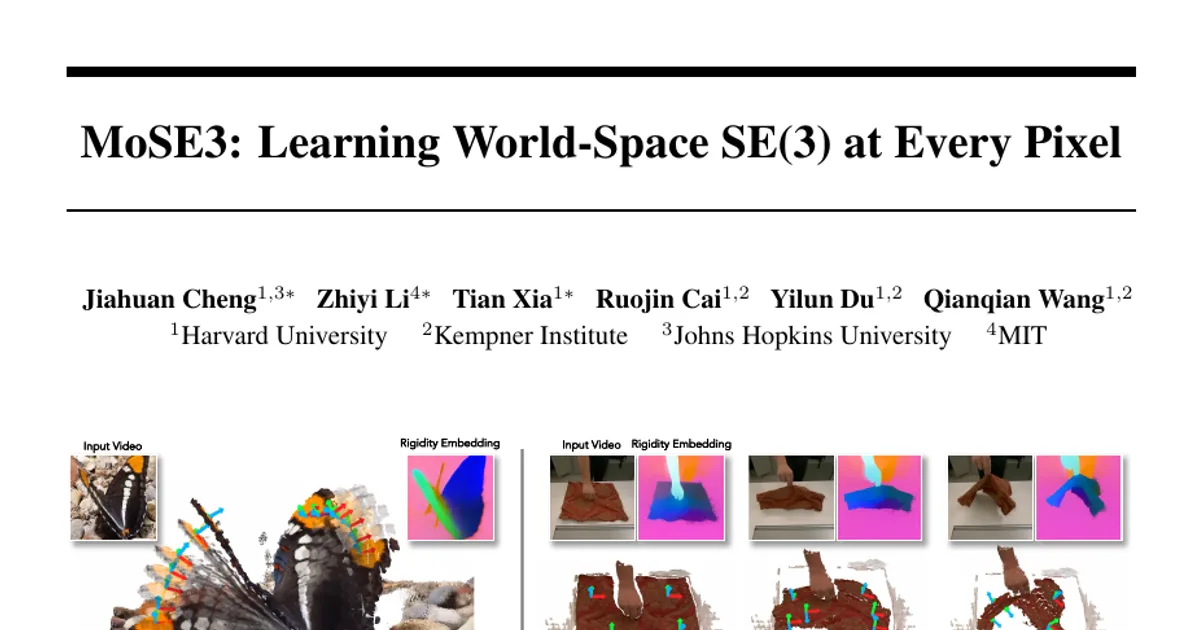
Il tracciamento denso di punti 3D è un paradigma importante per modellare il movimento nelle scene dinamiche. Tuttavia, la traiettoria di un punto è soltanto una curva di traslazione a 3 gradi di libertà per pixel: mostra dove si spostano i pixel, ma non la rotazione della parte sottostante né quali pixel si muovono insieme come un unico corpo. Proponiamo MoSE3, il primo modello feed-forward che predice il movimento SE(3) denso da video RGB monoculari, producendo per ogni pixel trasformazioni rigide complete a 6 gradi di libertà nello spazio del mondo. Il movimento SE(3) per pixel offre una rappresentazione più ricca di come si muove una scena: rotazione, traslazione e raggruppamento insieme. Predire direttamente SE(3) è difficile: le rotazioni si trovano su una varietà curva poco adatta alla regressione euclidea, e le annotazioni SE(3) sono particolarmente difficili da ottenere. Per affrontare queste difficoltà, MoSE3 predice SE(3) per pixel attraverso due rappresentazioni intermedie apprese congiuntamente, traiettorie di punti 3D ed embedding di rigidità, e ricava SE(3) adattando le trasformazioni in modo differenziabile all’interno di ciascun cluster rigido soft. Questo consente la predizione e la supervisione end-to-end. Per colmare la carenza di dati, introduciamo Art-Kubric, un dataset sintetico su larga scala con etichette dense di SE(3) e rigidità per oggetti articolati con ricche interazioni fisiche. MoSE3 raggiunge risultati allo stato dell’arte nella stima di SE(3) a livello di pixel, parte e oggetto su benchmark sia rigidi sia articolati, e nell’accuratezza media del tracciamento di punti 3D su tre dataset. Mostra inoltre una forte capacità di generalizzazione ai video del mondo reale, pur essendo stato addestrato esclusivamente su dati sintetici di movimento.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv