Ricerca
MixTok: tokenizzazione visiva adattiva con token 1D globali e raffinamento 2D sparso
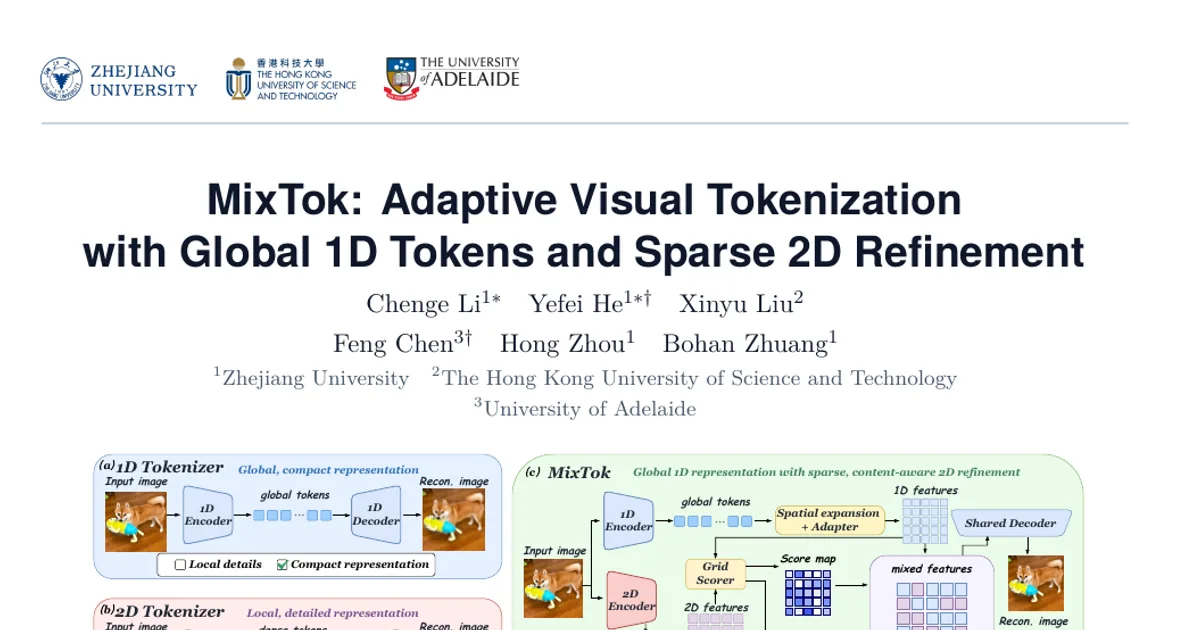
Una tokenizzazione visiva efficiente richiede un equilibrio tra la compattezza della rappresentazione e la conservazione dei dettagli dell’immagine. I tokenizer convenzionali basati su griglie distrib
- arXiv
- 2610.13181
- Pubblicato
- 2026-10-09
- Autori
- Chenge Li, Yefei He, Xinyu Liu, Feng Chen, Hong Zhou, Bohan Zhuang
Abstract degli autori
Una tokenizzazione visiva efficiente richiede un equilibrio tra la compattezza della rappresentazione e la conservazione dei dettagli dell’immagine. I tokenizer convenzionali basati su griglie distribuiscono i token uniformemente tra le posizioni spaziali, nonostante la complessità visiva non sia uniforme. I tokenizer 1D compatti, invece, aggregano le informazioni globali ma possono faticare a preservare i dettagli locali. Presentiamo MixTok, un tokenizer visivo ibrido che combina una rappresentazione globale 1D compatta con token 2D sparsi per il raffinamento locale. Un router adattivo al contenuto ordina le posizioni candidate in base alla priorità di raffinamento e determina il numero di token 2D per ciascuna immagine, rispettando un budget medio prefissato di token. Nelle posizioni con i punteggi più alti, le caratteristiche dei token 2D sostituiscono quelle spaziali recuperate dalla rappresentazione 1D; un decoder condiviso ricostruisce poi l’immagine a partire dalle caratteristiche così combinate. Su ImageNet 256 x 256, MixTok ottiene risultati altamente competitivi nella ricostruzione e nella generazione, con un rFID di 1,195 e un gFID di 1,95, a fronte di budget medi rispettivamente di circa 128 e 131 token di contenuto per immagine.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv