Ricerca
Molte risposte giuste, un solo esempio di addestramento: eliminare da GRPO il rumore dovuto a chi risponde nei sistemi di raccomandazione basati su LLM
Una richiesta di consigli su Reddit riceve diverse risposte, ciascuna con titoli differenti. Quando si addestra un sistema di raccomandazione basato su LLM su queste discussioni mediante apprendimento
- arXiv
- 2610.17771
- Pubblicato
- 2026-10-13
- Autori
- Xin Li, Hao Jiang, Jinghao Guo, Weisi Lin, Chau Yuen
Abstract degli autori
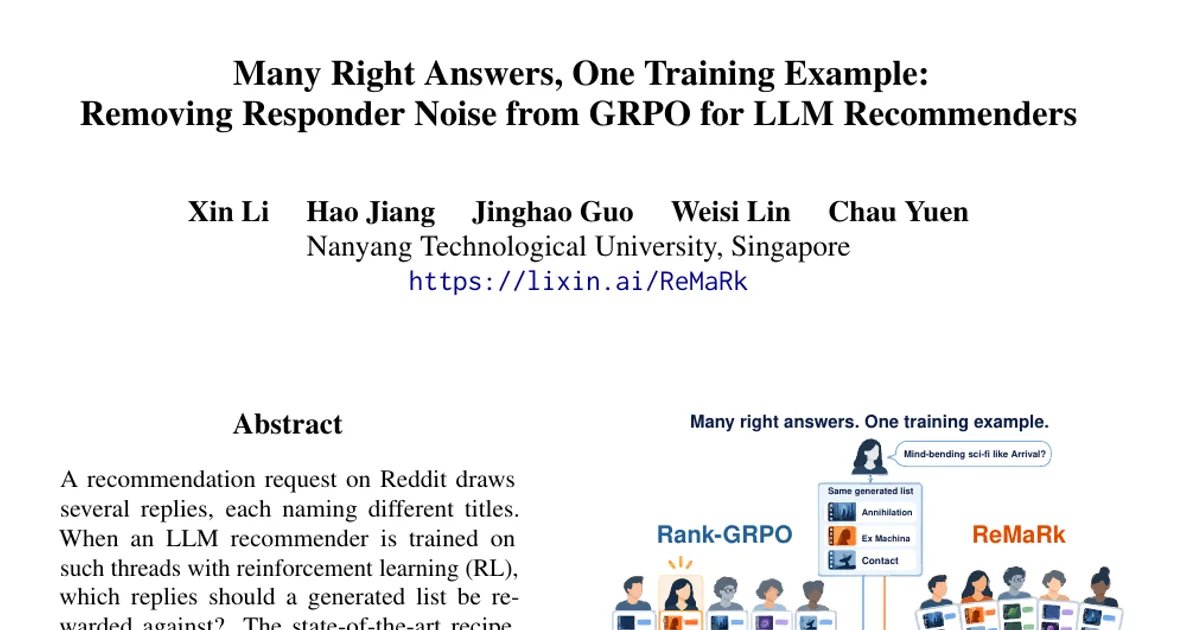
Una richiesta di consigli su Reddit riceve diverse risposte, ciascuna con titoli differenti. Quando si addestra un sistema di raccomandazione basato su LLM su queste discussioni mediante apprendimento per rinforzo (RL), rispetto a quali risposte va premiata una lista generata? Rank-GRPO, il metodo più avanzato, sceglie una risposta per ogni esempio di addestramento: il valore di vantaggio riflette quindi soprattutto quale risposta è stata estratta (l’85% della sua varianza), anziché la qualità della lista. Sosteniamo che l’RL debba basarsi sulla richiesta, non su ciascuna risposta, e proponiamo ReMaRk: valuta ogni lista una sola volta rispetto all’insieme dei titoli citati in tutte le risposte e campiona ciascuna richiesta con uguale probabilità. Questo riduce il costo dell’RL. Su sette backbone e tre dataset, ReMaRk raggiunge il recall di validazione ottenuto con 2.000 passi di RL per singola risposta impiegando dal 25 al 53% dei passi, e ottiene i risultati migliori con quel budget. Se l’addestramento prosegue finché nessuno dei due metodi migliora, ReMaRk non è mai significativamente inferiore a Rank-GRPO e, in quattro delle sette coppie, raggiunge il miglior risultato di Rank-GRPO con meno ore di GPU. Lo stesso criterio di ricompensa è utile anche su ProtoQA, dove circa 100 persone rispondono a ogni domanda: un risultato che suggerisce una regola semplice per l’RL in presenza di più risposte umane valide, ossia premiarle congiuntamente.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv