Ricerca
LVMT: Video Mask Transformer per la segmentazione video a lungo termine
I metodi attuali di segmentazione video online faticano a seguire gli oggetti in video lunghi e complessi, con occlusioni prolungate. Ipotizziamo che questo limite dipenda (i) dall’incapacità dei loro
- arXiv
- 2609.34895
- Pubblicato
- 2026-09-28
- Autori
- Narges Norouzi, Niccolò Cavagnero, Idil Esen Zulfikar, Bastian Leibe, Gijs Dubbelman, Daan de Geus
Abstract degli autori
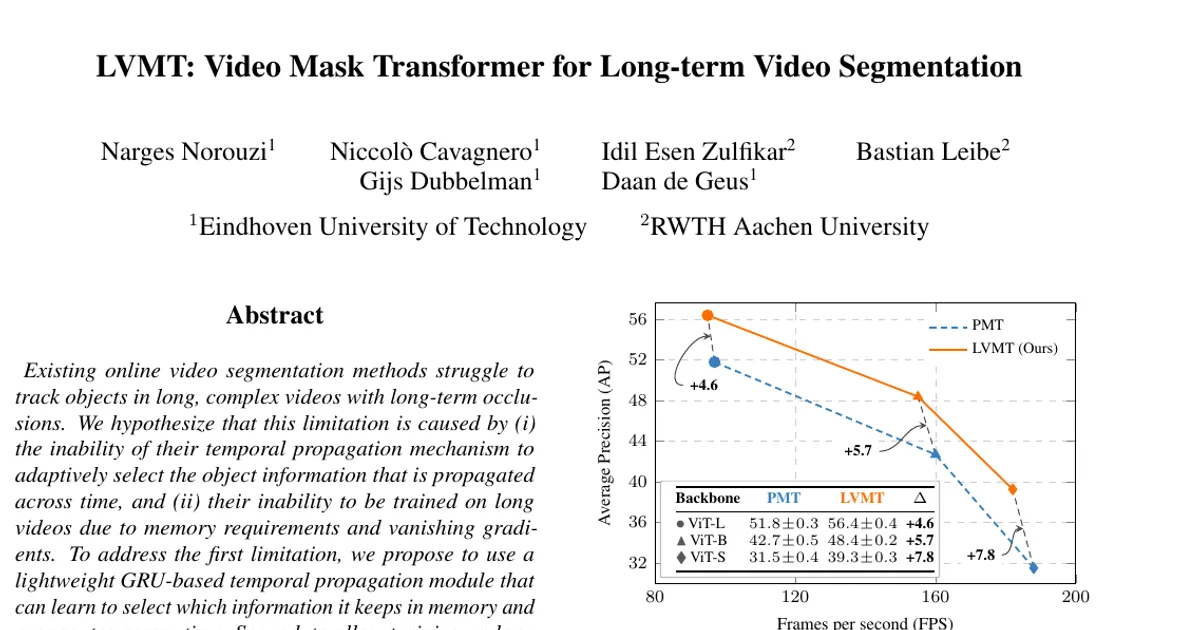
I metodi attuali di segmentazione video online faticano a seguire gli oggetti in video lunghi e complessi, con occlusioni prolungate. Ipotizziamo che questo limite dipenda (i) dall’incapacità dei loro meccanismi di propagazione temporale di selezionare in modo adattivo le informazioni sugli oggetti da propagare nel tempo e (ii) dall’impossibilità di addestrarli su video lunghi, a causa dei requisiti di memoria e della scomparsa dei gradienti. Per affrontare il primo limite, proponiamo un modulo leggero di propagazione temporale basato su GRU, capace di apprendere quali informazioni conservare in memoria e propagare nel tempo. Per consentire l’addestramento su video lunghi, introduciamo inoltre Truncated Query Propagation (TQP), una strategia in cui il modello elabora il video in blocchi di fotogrammi: le informazioni sugli oggetti seguiti vengono propagate da un blocco all’altro, mentre la retropropagazione avviene soltanto all’interno dei singoli blocchi. Questo permette una supervisione temporale più lunga senza problemi di esaurimento della memoria, costi aggiuntivi in fase di inferenza o scomparsa dei gradienti. Il modello risultante si chiama Long-term Video Mask Transformer (LVMT). Esperimenti approfonditi su sei benchmark mostrano che LVMT stabilisce un nuovo stato dell’arte in diversi compiti di segmentazione video, mantenendo la velocità del modello altamente efficiente su cui si basa e risultando 10X più veloce del precedente stato dell’arte. Codice: https://www.tue-mps.org/lvmt
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv