Ricerca
LongR: potenziare il ragionamento su contesti lunghi con l’apprendimento per rinforzo e ricompense dense basate sull’utilità
L’apprendimento per rinforzo (RL) è diventato un fattore chiave per il ragionamento dei modelli linguistici di grandi dimensioni (LLM). Questa capacità è altrettanto cruciale negli scenari con contest
- arXiv
- 2602.05758
- Pubblicato
- 2026-02-05
- Autori
- Qize Yu, Zijun Chen, Chen Wu, Yue Chen, Yiyao Yu, Tingfeng Hui, Bowen Ping, Junchi Yan, Baobao Chang
Abstract degli autori
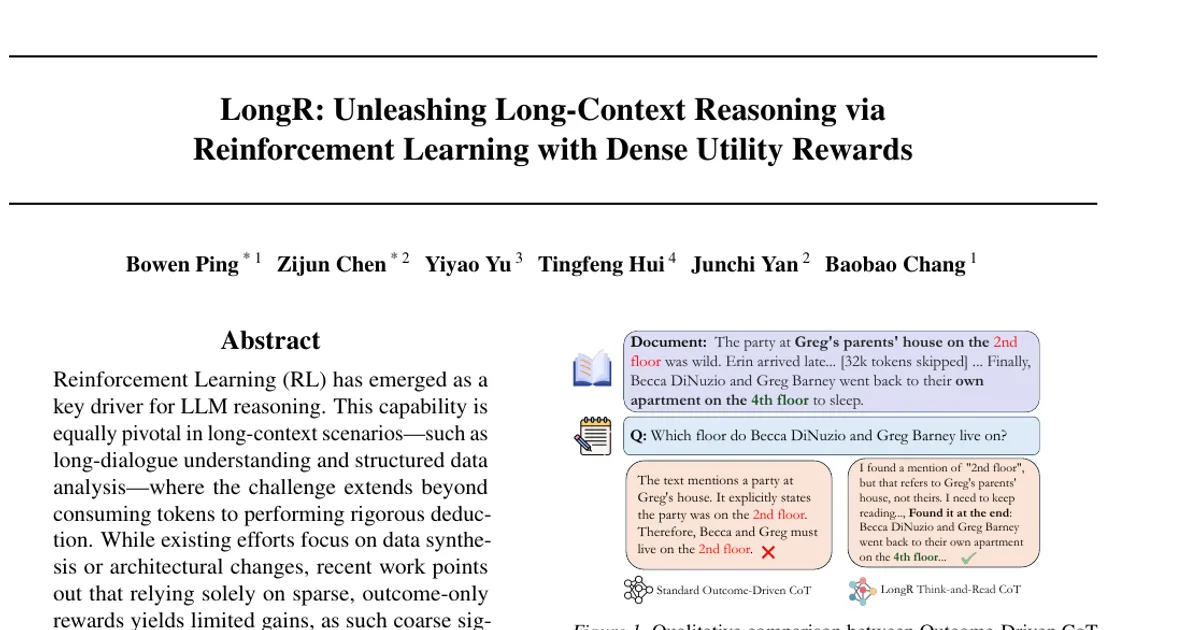
L’apprendimento per rinforzo (RL) è diventato un fattore chiave per il ragionamento dei modelli linguistici di grandi dimensioni (LLM). Questa capacità è altrettanto cruciale negli scenari con contesti lunghi, come la comprensione di dialoghi estesi e l’analisi di dati strutturati, in cui la sfida non è soltanto elaborare token, ma anche compiere deduzioni rigorose. Mentre i lavori esistenti si concentrano sulla sintesi dei dati o su modifiche architetturali, studi recenti indicano che affidarsi esclusivamente a ricompense sparse, basate solo sull’esito, produce miglioramenti limitati: segnali così grossolani spesso non bastano a guidare efficacemente il complesso ragionamento su contesti lunghi. Per affrontare il problema, proponiamo LongR, un framework unificato che migliora le prestazioni su contesti lunghi integrando un meccanismo dinamico «Think-and-Read», che alterna il ragionamento alla consultazione dei documenti, con una ricompensa di densità contestuale basata sul guadagno relativo di informazione, per quantificare l’utilità dei documenti pertinenti senza annotazioni delle evidenze. Nei test, LongR ottiene un miglioramento di oltre il 9\% su LongBench v2 e miglioramenti costanti su RULER e InfiniteBench, dimostrando una solida efficienza nell’esplorazione di contesti estesi. Inoltre, LongR migliora costantemente le prestazioni con diversi algoritmi di RL (per esempio, DAPO e GSPO). Infine, conduciamo analisi approfondite per esaminare l’impatto della lunghezza della catena di ragionamento sull’efficienza e la robustezza del modello rispetto agli elementi di distrazione.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv