Ricerca
Imparare a valutare prima di migliorare: induzione automatica di griglie di valutazione per agenti di ricerca automatizzati
Gli agenti autonomi di ricerca scientifica sono sempre più impiegati in processi scientifici completi, dalla revisione della letteratura all’analisi dei dati, alla sperimentazione e alla stesura di ra
- arXiv
- 2608.31076
- Pubblicato
- 2026-08-31
- Autori
- Xuehai Wang, Haowei Qin, Tongxin Liu, Junkai Li, Buqiang Xu, Jintian Zhang, Yijun Chen, Zirui Xue, Shumin Deng
Abstract degli autori
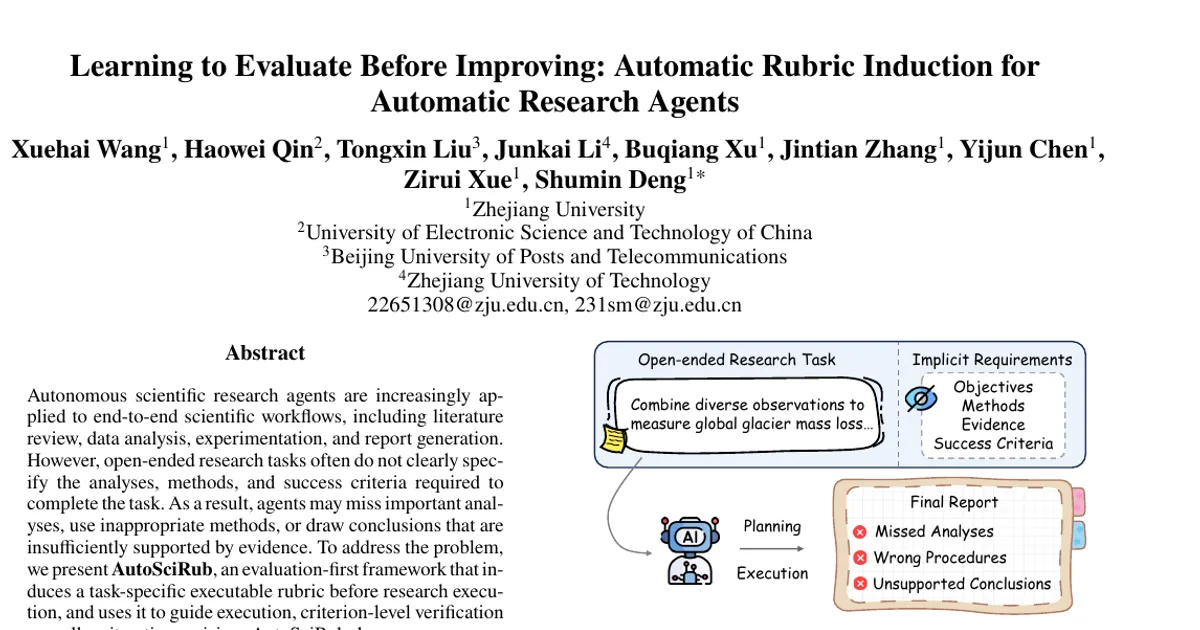
Gli agenti autonomi di ricerca scientifica sono sempre più impiegati in processi scientifici completi, dalla revisione della letteratura all’analisi dei dati, alla sperimentazione e alla stesura di rapporti. Tuttavia, nei compiti di ricerca aperti spesso non sono specificati chiaramente le analisi, i metodi e i criteri di successo necessari per completarli. Di conseguenza, gli agenti possono tralasciare analisi importanti, usare metodi inappropriati o trarre conclusioni non sufficientemente suffragate dalle prove. Per affrontare questo problema, presentiamo AutoSciRub, un framework che parte dalla valutazione: prima dell’esecuzione della ricerca, genera una griglia di valutazione eseguibile e specifica per il compito, che poi usa per guidare l’esecuzione, la verifica di ciascun criterio e le revisioni iterative. AutoSciRub scompone un’istruzione non sufficientemente specificata in obiettivi scientifici elementari, li fonda sulla letteratura pertinente e sui dati visibili nell’ambito del compito e formula criteri specifici, attuabili e verificabili. La griglia risultante rende espliciti i requisiti sperimentali e probatori impliciti, offrendo indicazioni per gli esperimenti e le analisi. Durante la revisione, la verifica guidata dalla griglia individua i criteri non soddisfatti e consente di perfezionare in modo mirato il rapporto di ricerca e gli artefatti che lo supportano. Su ResearchClawBench, AutoSciRub migliora sistematicamente tutte le configurazioni testate, con un incremento medio di 2,08 punti su tre LLM di base usando l’infrastruttura di esecuzione Codex mantenuta fissa e di 2,95 punti su tre infrastrutture di esecuzione per agenti usando DeepSeek-V4-Flash come modello di base fisso. Su un sottoinsieme di 20 compiti selezionati casualmente da AstaBench E2E Discovery, AutoSciRub ottiene inoltre un miglioramento medio di 16,8 punti su tre infrastrutture di esecuzione per agenti, mantenendo invariato o aumentando il numero di compiti completati con successo. Questi risultati dimostrano che partire dalla valutazione fornisce un meccanismo di controllo efficace e generalizzabile per la ricerca scientifica autonoma (Codice: https://github.com/zjunlp/AutoSciRub).
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv