Ricerca
Imparare a distinguere le strutture delle scene rende scalabile l’apprendimento autosupervisionato della profondità
La stima autosupervisionata della profondità da una singola immagine è promettente perché può crescere di scala grazie ai dati privi di etichette, ma i metodi esistenti spesso peggiorano quando vengon
- arXiv
- 2610.23600
- Pubblicato
- 2026-10-16
- Autori
- Mengtan Zhang, Yuchuan Cui, Yu Ma, Zizhan Guo, Wei Ye, Rui Fan
Abstract degli autori
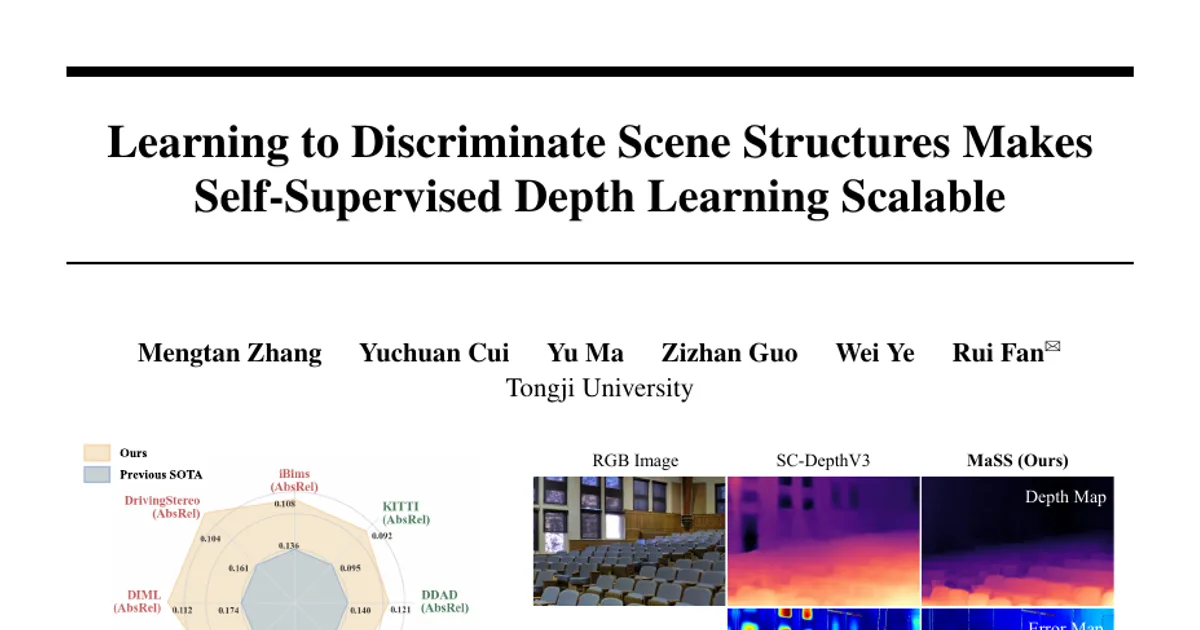
La stima autosupervisionata della profondità da una singola immagine è promettente perché può crescere di scala grazie ai dati privi di etichette, ma i metodi esistenti spesso peggiorano quando vengono addestrati su scene diverse. Questo studio rileva che, nell’apprendimento autosupervisionato, i modelli tendono a codificare caratteristiche strutturali proprie dei singoli dataset anziché una geometria delle scene trasferibile, causando conflitti di ottimizzazione tra domini. Per affrontare il problema, lo studio propone il framework MaSS, con l’obiettivo di rendere scalabile l’apprendimento autosupervisionato della profondità su dati eterogenei. MaSS introduce un percorso dedicato alla rappresentazione strutturale, esplicitamente separato dalle caratteristiche contestuali. Un nuovo obiettivo di discriminazione della struttura delle scene guida questo percorso nell’apprendimento di rappresentazioni strutturali generalizzabili, sensibili alla disposizione spaziale e utilizzate per la decodifica della profondità. Addestrato e valutato su quattro dataset diversi, sia separatamente sia congiuntamente, MaSS supera nettamente i precedenti metodi autosupervisionati ed è il primo a trarre sistematicamente beneficio dall’addestramento su domini misti. La valutazione zero-shot su altri otto dataset ne dimostra inoltre la notevole capacità di generalizzazione, in particolare sulle scene completamente fuori distribuzione. Il codice sorgente è disponibile pubblicamente all’indirizzo https://mias.group/MaSS.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv