Ricerca
LayerRecall: un router di memoria condizionato dallo stato per la coerenza a lungo termine nella generazione video
La diffusione video autoregressiva consente di generare video lunghi in modo scalabile, producendo segmenti a partire da un contesto recente di dimensioni limitate. Sebbene il caching basato sulla vic
- arXiv
- 2608.28460
- Pubblicato
- 2026-08-28
- Autori
- Yixuan Ding, Jiahao Kong, Wei Huang, Ruijie Quan, Yi Yang
Abstract degli autori
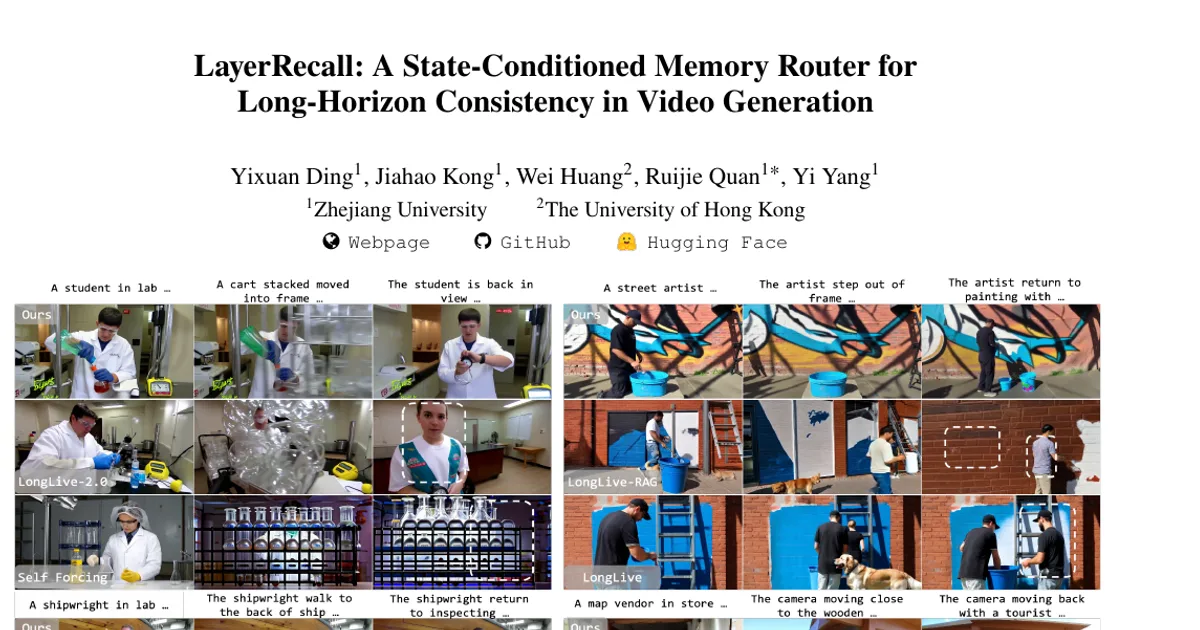
La diffusione video autoregressiva consente di generare video lunghi in modo scalabile, producendo segmenti a partire da un contesto recente di dimensioni limitate. Sebbene il caching basato sulla vicinanza temporale preservi la continuità locale, elimina gli indizi del passato necessari quando ricompaiono soggetti, oggetti, scene o attributi. I meccanismi di memoria esistenti danno ai modelli accesso a informazioni lontane nel tempo, ma il solo accesso non ne garantisce un uso efficace. La nostra analisi rivela che i livelli dei DiT video mostrano preferenze diverse per il contesto attuale, recente e lontano: per sfruttare la memoria a lungo termine occorre quindi decidere sia che cosa recuperare sia dove usarlo. Presentiamo LayerRecall, un router di memoria condizionato dal contesto attuale e selettivo per livello, che recupera gli stati K/V storici pertinenti e li inserisce soltanto nei livelli sensibili alla memoria specifici del backbone, preservando altrove l’attenzione locale. Per ridurre la dipendenza dai rari video di alta qualità a lungo termine e da etichette esplicite di allocazione della memoria, proponiamo inoltre Cross-Horizon Prediction Matching (CHPM), che usa un riferimento con accesso privilegiato a un contesto esteso per supervisionare il router a memoria limitata nello spazio delle predizioni. Su 100 prompt di valutazione multi-shot, LayerRecall ottiene i migliori risultati complessivi su MemoBench e MovieBench e risultati pari a quelli del proprio backbone su VBench-Long, dimostrando una maggiore capacità di recuperare informazioni a lungo termine senza sacrificare la continuità locale. Le analisi qualitative rivelano inoltre un’autocorrezione guidata dalla memoria: attributi locali inizialmente non corrispondenti tornano al loro aspetto storico senza azzerare il movimento in corso né la struttura della scena. Ulteriori analisi mostrano la portabilità tra backbone e un overhead trascurabile in fase di inferenza.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv