Ricerca
I modelli linguistici imparano a migliorare i modelli linguistici
I modelli linguistici di grandi dimensioni (LLM) sono sempre più usati per automatizzare la ricerca sull’IA, compreso lo sviluppo di modelli linguistici (LM), e offrono una possibile strada verso l’au
- arXiv
- 2610.23344
- Pubblicato
- 2026-10-16
- Autori
- Minhua Lin, Zijun Wang, Zewen Liu, Zhaotian Weng, Bing He, Zhan Shi, Benoit Dumoulin, Xiang Zhang, Suhang Wang, Hanqing Lu
Abstract degli autori
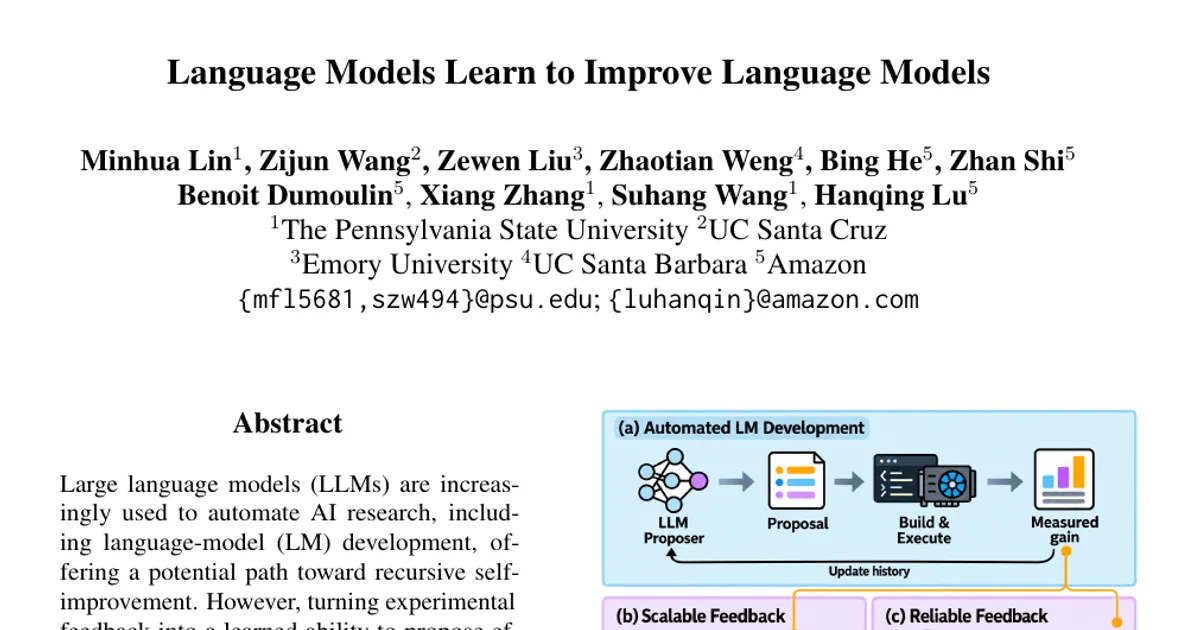
I modelli linguistici di grandi dimensioni (LLM) sono sempre più usati per automatizzare la ricerca sull’IA, compreso lo sviluppo di modelli linguistici (LM), e offrono una possibile strada verso l’automiglioramento ricorsivo. Tuttavia, trasformare il feedback sperimentale in una capacità appresa di proporre miglioramenti efficaci per modelli diversi presenta due difficoltà. La prima è il costo dell’addestramento di questa capacità con feedback reale: l’apprendimento per rinforzo (RL) richiede di valutare decine di migliaia di proposte, ciascuna delle quali potrebbe richiedere un addestramento completo del modello. Anche con dieci ore-GPU per ogni esecuzione, la sola raccolta delle ricompense consumerebbe centinaia di migliaia di ore-GPU, rendendo necessario un sostituto meno costoso. La seconda è che il feedback di questo sostituto può diventare inaffidabile quando, al cambiare della distribuzione delle proposte, l’ottimizzazione della policy favorisce quelle il cui valore è sovrastimato. Per affrontare queste difficoltà, proponiamo LM2LM, che addestra gli LLM con l’RL a generare proposte efficaci per migliorare i LM. Per fornire feedback su larga scala, usiamo come modello di ricompensa per l’RL un research world model (RWM): un LLM congelato che predice i miglioramenti prodotti dalle proposte a partire da resoconti di esperimenti reali forniti nel contesto. Per mantenere affidabile il feedback, eseguiamo periodicamente le proposte della policy corrente a cui l’RWM assegna i punteggi più alti e aggiungiamo al suo contesto i risultati misurati. In otto ambienti di sviluppo di LM autoregressivi e a diffusione, le valutazioni basate su esecuzioni reali su compiti tenuti da parte mostrano che LM2LM consente a Qwen3.8-27B di superare GPT-6-sol, anche quando a GPT-6-sol vengono forniti nel contesto 300 resoconti di esperimenti reali, con un costo di generazione dei dati inferiore del 33%. LM2LM si generalizza inoltre a una famiglia di modelli mai incontrata durante l’addestramento.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv