Ricerca
Articolazioni, camera, azione: generazione congiunta di movimento 3D e video per rig arbitrari
I modelli di generazione video sono ormai in grado di rappresentare movimenti notevolmente realistici. Non è però chiaro come usare questi movimenti al di là dei pixel: per animare uno specifico asset
- arXiv
- 2610.28632
- Pubblicato
- 2026-10-20
- Autori
- Noam Rotstein, Yoad Tewel, Chen Tessler, Haggai Maron, Gal Chechik, Or Litany, Yoni Kasten, Yuval Atzmon
Abstract degli autori
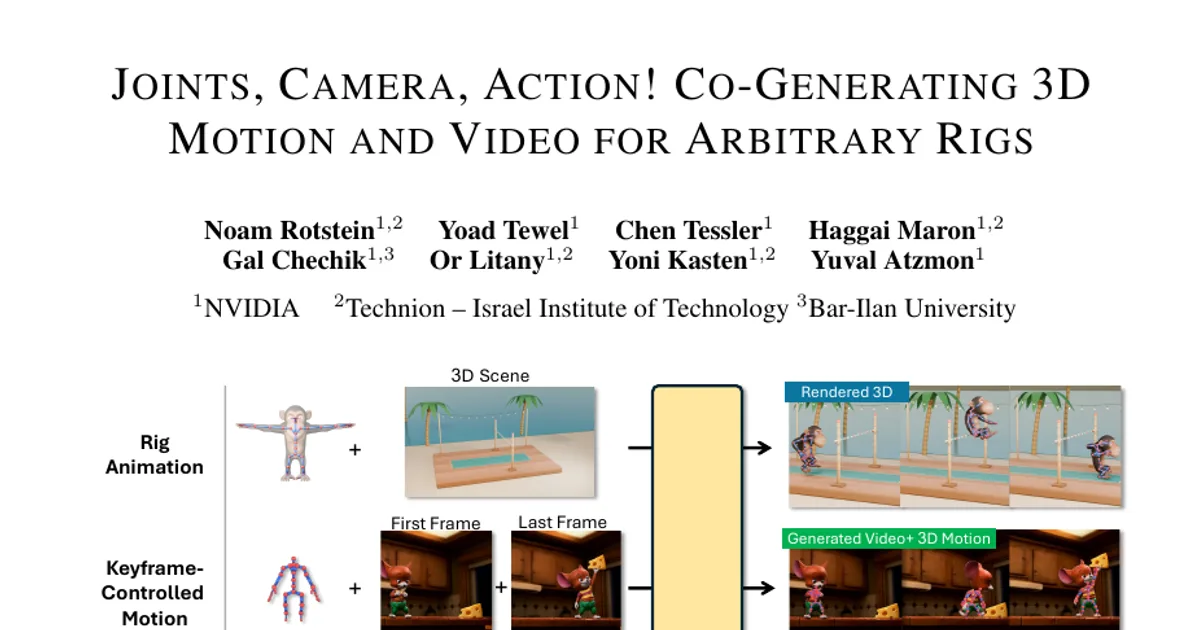
I modelli di generazione video sono ormai in grado di rappresentare movimenti notevolmente realistici. Non è però chiaro come usare questi movimenti al di là dei pixel: per animare uno specifico asset 3D e riprodurre l’animazione nella sua scena 3D. Per esempio, un modello video può mostrare una scimmia che salta sopra una sbarra, ma non può restituire quel salto come movimento 3D riproducibile e collocato nella scena 3D. Presentiamo un modello che genera congiuntamente, e in modo diretto, il video e il movimento 3D per qualsiasi rig fornito, insieme a una telecamera che allinea il movimento alla scena. I precedenti modelli per video e movimento si limitano agli scheletri umani, spesso aggiungendo miliardi di parametri, oppure triangolano il movimento 3D a partire da mappe di pose 2D generate. Noi manteniamo invece il movimento 3D in un modello separato, che supporta scheletri arbitrari, e lo colleghiamo a un modello video preaddestrato tramite un piccolo numero di livelli di cross-attention. Questa separazione consente al modello del movimento di imparare prima come si muovono gli scheletri da dati contenenti solo movimenti, più facili da ottenere e ampliare rispetto a video abbinati ai movimenti. Inoltre, il nostro modello impara a individuare ogni articolazione nei fotogrammi del video, permettendoci di ricostruire la telecamera e collocare il movimento 3D nella scena. Per addestrarlo su molti scheletri, usiamo un editor video generativo per collocare asset 3D animati in scene adatte alle loro azioni, selezionando le modifiche in modo che il movimento noto degli asset resti valido. Insieme ai video di esseri umani e robot, questo produce quasi 200K coppie di addestramento. Le nostre valutazioni mostrano che il modello anima rig diversi a partire dal testo con maggiore fedeltà rispetto alle pipeline che partono dal video e che il suo movimento risponde alla scena circostante. Può anche convertire video in movimenti del rig e movimenti del rig in video, oltre a consentire il controllo del movimento 3D tramite fotogrammi chiave. Video e ulteriori risultati sono disponibili sulla pagina del progetto: https://research.nvidia.com/labs/par/projects/jca/.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv