Ricerca
JevAgentHarness: valutare, distribuire e addestrare modelli decisionali che condividono il controllo con gli LLM
Gli agenti basati su modelli linguistici di grandi dimensioni (LLM) oggi correggono software, usano computer e assistono i clienti. Ma i loro harness, i programmi che li eseguono, chiamano un LLM di g
- arXiv
- 2610.21412
- Pubblicato
- 2026-10-15
- Autori
- Kunlun Zhu, Tao Feng, Xu Han, Heng Wang, Ling Yang, Xiangru Tang, Jiaxuan You, Heng Ji
Abstract degli autori
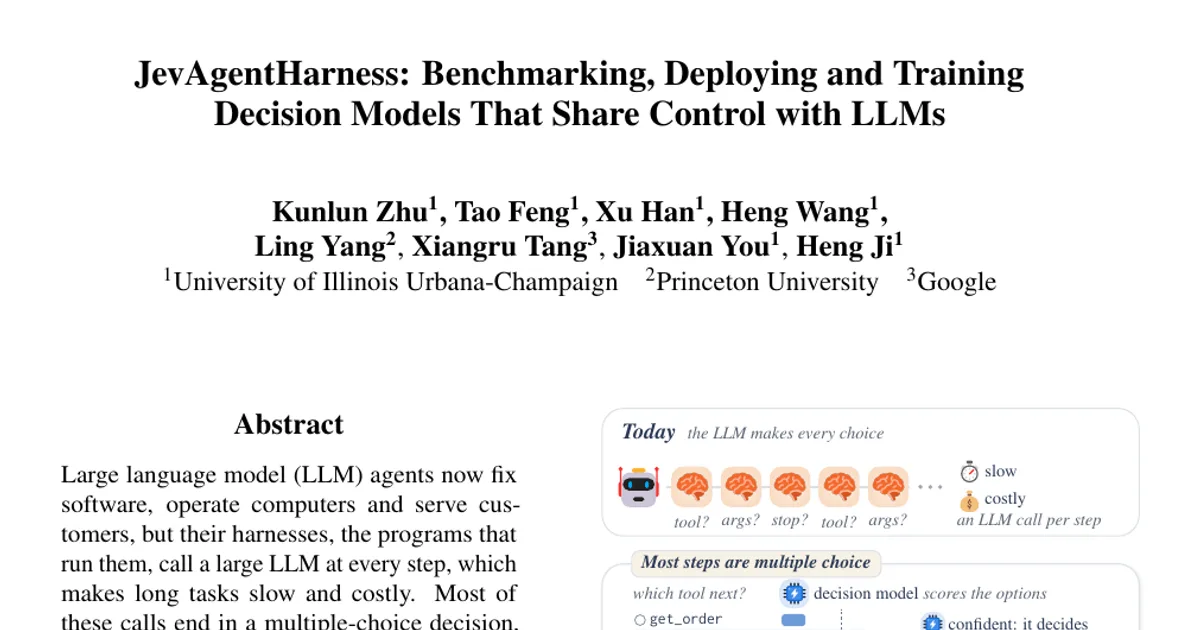
Gli agenti basati su modelli linguistici di grandi dimensioni (LLM) oggi correggono software, usano computer e assistono i clienti. Ma i loro harness, i programmi che li eseguono, chiamano un LLM di grandi dimensioni a ogni passaggio, rendendo i compiti lunghi lenti e costosi. La maggior parte di queste chiamate si conclude con una scelta tra più opzioni, per esempio quale strumento usare subito dopo. Modelli decisionali come Jev rispondono direttamente a queste domande, impiegando una frazione del tempo e del costo di una chiamata a un LLM. Ci chiediamo come un harness possa delegare queste scelte a un modello decisionale senza compromettere molto il tasso di successo. Per valutare i modelli decisionali nei compiti degli agenti, abbiamo creato AgentDecisionBench, che li mette alla prova dalle domande isolate fino al controllo di un agente in esecuzione, usando benchmark pubblici e il nostro ambiente DecisionGym. Il modello decisionale più accurato sulle domande isolate ha risolto solo il 69,5% dei compiti degli agenti e, senza una soglia di confidenza calibrata, delegare la scelta degli strumenti ha ridotto il tasso di successo di 19,0 punti. Sulla base di questi risultati, abbiamo poi progettato JevAgentHarness, che calibra tale soglia per ogni scelta sulle traiettorie dell’agente stesso e, al di sotto di essa, lascia decidere all’LLM. Poiché i modelli decisionali esistenti non incontrano mai gli stati raggiunti da un agente dopo i propri errori, abbiamo addestrato AgentDecision-4B, un modello aperto 4B, su questi stati, usando le risposte di Jev come etichette. Su compiti diversi da quelli dei suoi dati di addestramento, l’agente ne ha risolto il 91,5% con AgentDecision-4B e l’82,0% con Jev. Su compiti simili a quelli dei rispettivi dati di addestramento, i modelli 4B addestrati in questo modo hanno ridotto il costo degli agenti dell’81,1-89,0% e li hanno resi fino a 2,5 volte più veloci, senza una perdita di 3 o più punti nel tasso di successo dei compiti. I modelli, i dati e l’harness saranno pubblicati su https://github.com/JevAgentHarness/JevAgentHarness.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv