Ricerca
Jev-ToM: valutare la teoria della mente nei modelli decisionali tipizzati
Gli assistenti conversazionali e collaborativi valutano ripetutamente ciò che un interlocutore sa, crede o intende fare. I modelli decisionali tipizzati offrono una potenziale alternativa ai grandi mo
- arXiv
- 2610.18610
- Pubblicato
- 2026-10-13
- Autori
- Kawai Chung, Chunkit Chan, Yuxuan Liu, Yauwai Yim, Xi Yang, Wenbin Hu, Huihao Jing, Chiu Yeung Tang, Changxuan Fan, Ki Sen Hung, Tsun On Kwok, Haoran Li
Abstract degli autori
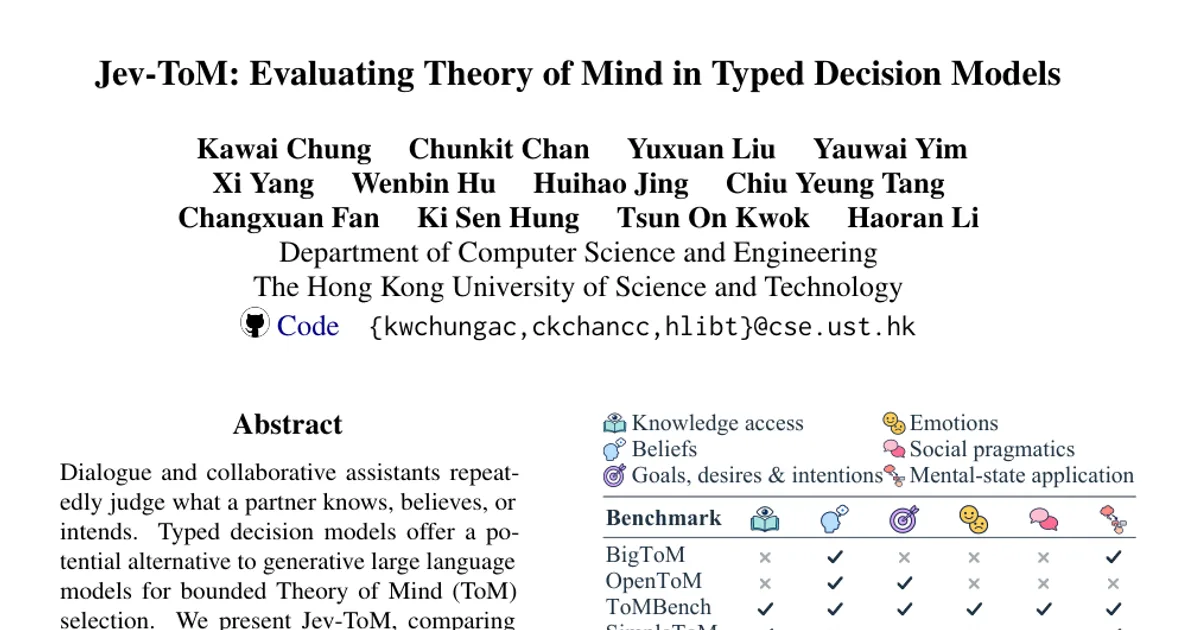
Gli assistenti conversazionali e collaborativi valutano ripetutamente ciò che un interlocutore sa, crede o intende fare. I modelli decisionali tipizzati offrono una potenziale alternativa ai grandi modelli linguistici generativi per la selezione circoscritta nell’ambito della teoria della mente (ToM). Presentiamo Jev-ToM, confrontando cinque modelli decisionali tipizzati e sette modelli generativi di riferimento su 11.117 domande testuali in inglese tratte da nove benchmark di ToM, suddivise in sei gruppi di capacità. TypeSafe Jev raggiunge un’accuratezza del 73,2% bilanciata per fonte, controlli nativi inclusi, e si colloca al primo o al secondo posto in tutte e sei le capacità, primeggiando per credenze, obiettivi/desideri/intenzioni ed emozioni. Gli altri modelli tipizzati mostrano punti di forza distinti nei diversi compiti. Confronti separati sull’impiego delle risorse suggeriscono che Jev potrebbe ridurre i costi e i tempi di attesa della selezione ToM ripetuta. La selezione basata sul grado di fiducia resta dipendente dal benchmark, e le motivazioni fornite possono correggere errori o ribaltare risposte corrette a seconda di come vengono associate. L’ampliamento dei candidati mette in luce problemi distinti di selezione e di validità dell’output. Gli indizi ricavati da domande correlate spiegano la maggior parte dei miglioramenti ottenuti da Jev nelle fasi successive, mentre gli effetti degli stati previsti dipendono dal compito. I risultati motivano la sperimentazione di Jev come componente di selezione ToM negli assistenti, dando priorità, nell’integrazione, alla calibrazione del grado di fiducia specifica per ciascun compito, alla progettazione dei candidati e alla validazione dell’output.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv