Ricerca
Inseguimento del percorso attento ai consumi energetici: analisi comparativa tra apprendimento per rinforzo e NMPC per i veicoli elettrici
Le strategie di controllo per l’inseguimento del percorso devono in genere conciliare due obiettivi: ridurre al minimo gli scostamenti da un percorso di riferimento e mantenere profili di velocità reg
- arXiv
- 2610.08112
- Pubblicato
- 2026-10-06
- Autori
- Mohamed Sabaa, Mostafa Emam
Abstract degli autori
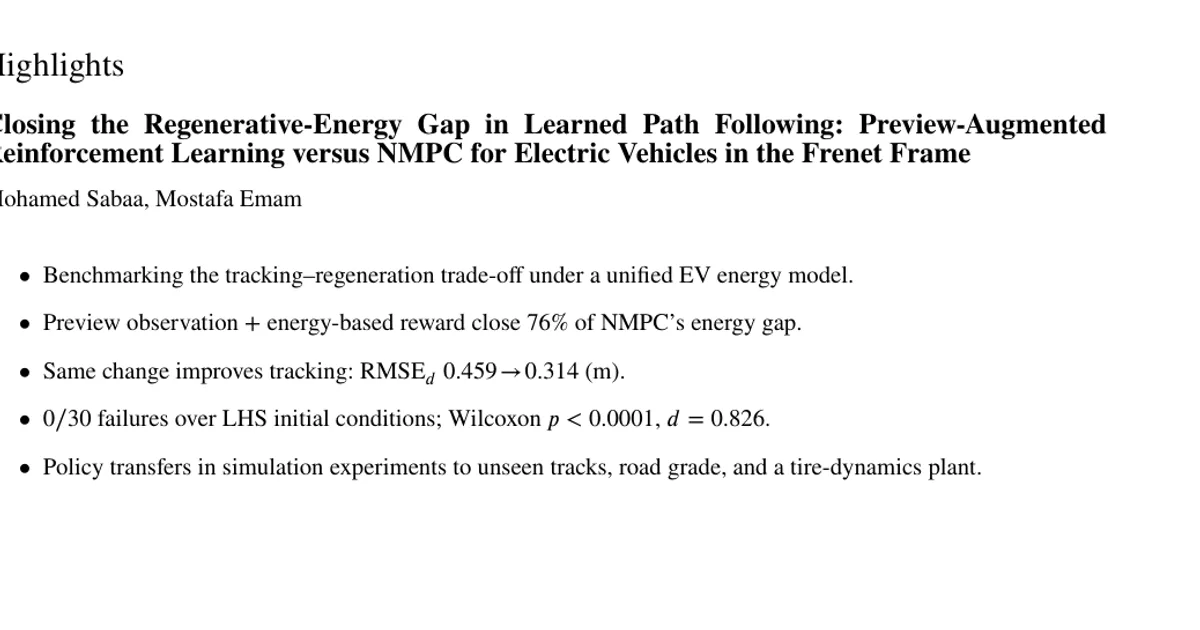
Le strategie di controllo per l’inseguimento del percorso devono in genere conciliare due obiettivi: ridurre al minimo gli scostamenti da un percorso di riferimento e mantenere profili di velocità regolari. Il secondo obiettivo è particolarmente importante per i veicoli elettrici, la cui autonomia limitata può essere aumentata recuperando energia attraverso la frenata rigenerativa, una possibilità non ancora studiata a sufficienza nella letteratura. In questo lavoro confrontiamo quattro controllori utilizzando per tutti un unico modello cinematico del veicolo basato sul sistema di riferimento di Frenet e un modello energetico validato (VT-CPEM) che rappresenta esplicitamente la frenata rigenerativa. Implementiamo i seguenti controllori: controllo predittivo non lineare basato su modello (NMPC), Proximal Policy Optimization (PPO), un controllore di riferimento con retroazione di stato di Ackermann a guadagni programmati (PID-SF) e un controllore geometrico di riferimento Stanley. Per soddisfare i requisiti di funzionamento in tempo reale, implementiamo l’NMPC usando CasADi con compilazione JIT. Addestriamo inoltre PPO su tracciati rettilinei e con curve a S tradizionali, per poi trasferire con successo la politica, senza modificarla, a tracciati mai visti: un cambio di corsia ISO 3888-1, una chicane, spline parametrizzate generate casualmente e una strada con pendenza di $\pm3^\circ$. La politica si trasferisce inoltre, senza ulteriore addestramento, a un modello dinamico monotraccia del veicolo con pneumatici lineari, ottenendo prestazioni iniziali accettabili, successivamente ottimizzate con un breve fine-tuning. Dimostriamo così che il nostro PPO è facilmente trasferibile a modelli del veicolo più completi. Concludiamo con un’analisi delle prestazioni dei controllori sviluppati e discutiamo alcune idee per lavori futuri.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv