Ricerca
Imparare a correggere la geometria nei video generati
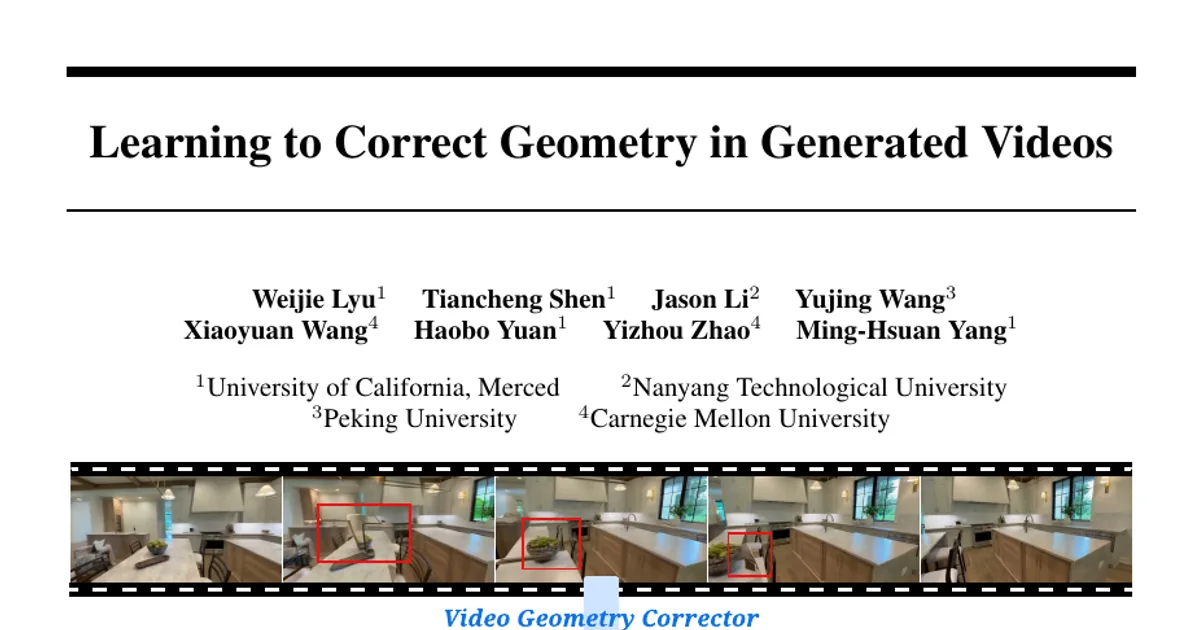
I video generati perdono spesso coerenza geometrica quando la camera si muove: le strutture si deformano al variare del punto di vista, la parallasse diventa incoerente e un movimento fluido della cam
- arXiv
- 2610.23856
- Pubblicato
- 2026-10-16
- Autori
- Weijie Lyu, Tiancheng Shen, Jason Li, Yujing Wang, Xiaoyuan Wang, Haobo Yuan, Yizhou Zhao, Ming-Hsuan Yang
Abstract degli autori
I video generati perdono spesso coerenza geometrica quando la camera si muove: le strutture si deformano al variare del punto di vista, la parallasse diventa incoerente e un movimento fluido della camera può trasformarsi in una sequenza di stacchi simili a cambi di inquadratura. Sosteniamo che questo problema dipenda in larga misura dai dati. Nei corpora video su scala web, gran parte del movimento visibile proviene da oggetti in movimento ripresi da camere fisse o che si muovono poco: i dati offrono quindi solo una supervisione limitata sui cambiamenti d’aspetto dovuti al variare del punto di vista. Per affrontare il problema, proponiamo Video Geometry Corrector (VGC), un modello da video a video che interviene a posteriori ed è addestrato con una supervisione sintetica basata su coppie. Partendo da video reali con movimenti di camera diversi e annotazioni di posa, costruiamo VG-Pairs mediante una pipeline che genera dati sintetici per la supervisione basata su coppie. Ogni clip video viene usato come obiettivo geometricamente coerente e abbinato a una versione distorta, sintetizzata da un modello di inpainting da immagine a video preaddestrato mediante fotogrammi chiave adattati alla traiettoria. VGC impara a trasformare l’input distorto nell’obiettivo geometricamente coerente senza modificare il generatore d’origine e usa il flusso ottico come indizio ausiliario per distinguere il movimento della camera da quello degli oggetti. Gli esperimenti su benchmark condizionati dalla posa e guidati da prompt mostrano che VGC migliora la coerenza geometrica con diversi generatori d’origine; il passaggio a un backbone più grande estende ulteriormente il framework verso un perfezionamento più generale dei video.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv