Ricerca
HumanSkill-4D: interrogazione in linguaggio naturale di avatar gaussiani animabili nello spazio e nel tempo senza addestramento
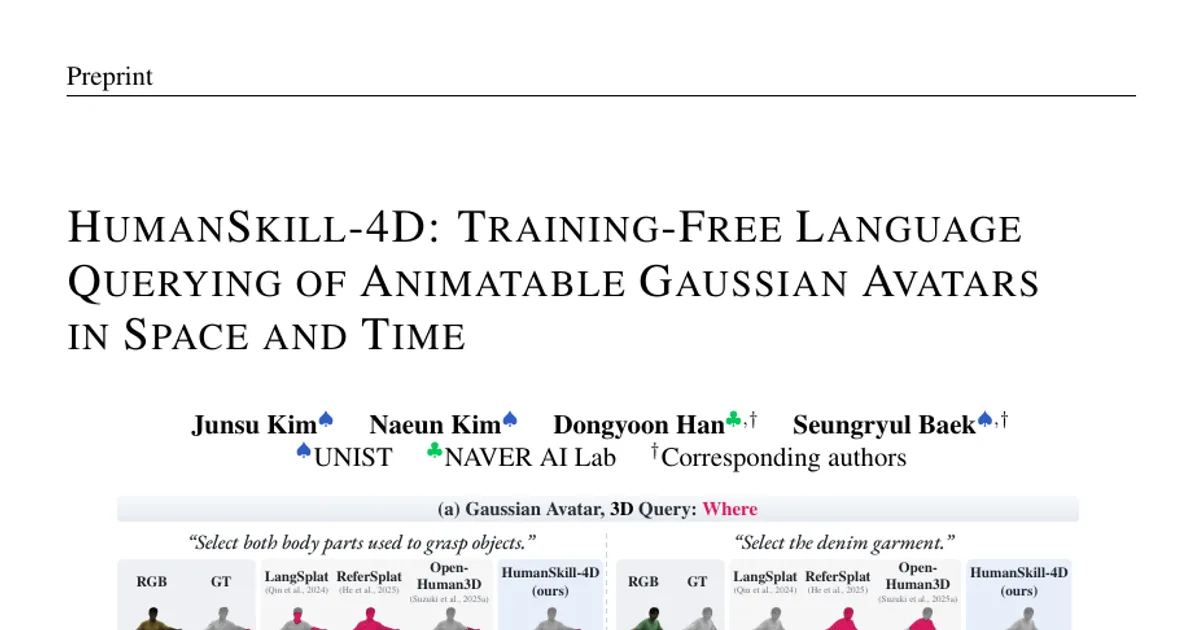
Introduciamo la segmentazione referenziale degli avatar, che seleziona regioni di avatar gaussiani animabili a partire da richieste in linguaggio naturale. Una richiesta può anche specificare una posa
- arXiv
- 2610.24452
- Pubblicato
- 2026-10-17
- Autori
- Junsu Kim, Naeun Kim, Dongyoon Han, Seungryul Baek
Abstract degli autori
Introduciamo la segmentazione referenziale degli avatar, che seleziona regioni di avatar gaussiani animabili a partire da richieste in linguaggio naturale. Una richiesta può anche specificare una posa o un movimento per selezionare gli intervalli corrispondenti. Questo permette agli utenti di interagire con gli avatar per apportare modifiche locali ed esaminare i movimenti. Tuttavia, effettuare queste selezioni con i metodi esistenti di Gaussian splatting basati sul linguaggio presenta due difficoltà: parti del corpo e indumenti adiacenti sono difficili da distinguere e possono essere indicati indirettamente (ambiguità delle regioni), mentre movimenti molto specifici possono apparire simili nelle immagini RGB (ambiguità del movimento). Affrontiamo queste difficoltà con HumanSkill-4D, un sistema senza addestramento che condivide tra gli avatar un modello linguistico multimodale di grandi dimensioni (MLLM) e operatori geometrici. Per ogni avatar, una memoria semantica collega le categorie di parti del corpo e indumenti a regioni gaussiane persistenti e a descrizioni dell’aspetto. L’MLLM usa i nomi e le descrizioni delle categorie per selezionarle in base all’aspetto, alle relazioni o alla funzione. Per trovare gli intervalli corrispondenti, combina gli operatori in programmi che verificano le condizioni espresse nella richiesta sulle traiettorie delle articolazioni che guidano il movimento, conservate in una memoria dei movimenti. Le categorie scelte e i risultati degli operatori rendono tracciabili le selezioni, mentre la possibilità di combinare o aggiungere operatori permette di gestire nuove condizioni relative al movimento. Per valutare questo compito, introduciamo tre benchmark annotati da esseri umani e mostriamo che HumanSkill-4D supera i metodi di riferimento nella segmentazione delle parti del corpo e nella segmentazione referenziale 3D e 4D, con memorie compatte e solo pochi minuti di preparazione per avatar.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv