Ricerca
Nascondere la latenza degli strumenti in un agente vocale a cascata sul dispositivo mediante esecuzione speculativa
Gli assistenti vocali che usano strumenti esterni eseguono di norma in sequenza il riconoscimento automatico del parlato, l’inferenza del modello linguistico di grandi dimensioni (LLM) e l’esecuzione
- arXiv
- 2610.07641
- Pubblicato
- 2026-10-06
- Autori
- Kyudan Jung, Hyunsin Park, Yoonhyung Lee, Jinhwan Park, Jinhyeok Yang, KiHyun Nam, Jaegul Choo, Jinkyu Lee
Abstract degli autori
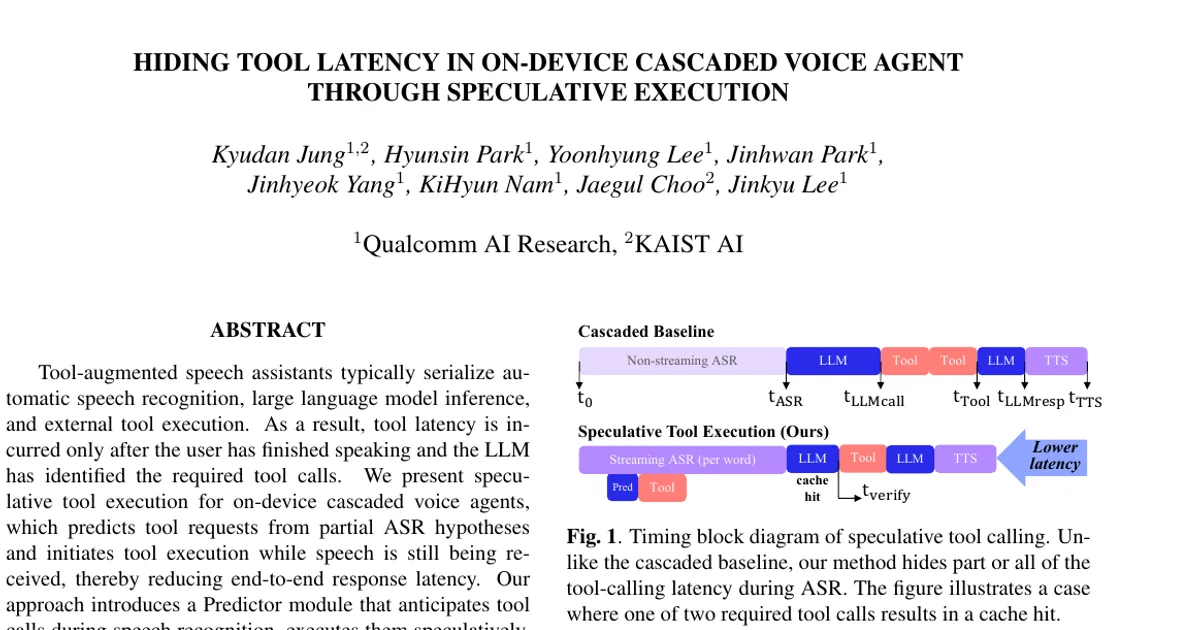
Gli assistenti vocali che usano strumenti esterni eseguono di norma in sequenza il riconoscimento automatico del parlato, l’inferenza del modello linguistico di grandi dimensioni (LLM) e l’esecuzione degli strumenti. Di conseguenza, la latenza degli strumenti si aggiunge solo dopo che l’utente ha finito di parlare e l’LLM ha individuato le chiamate necessarie. Presentiamo un metodo di esecuzione speculativa degli strumenti per agenti vocali a cascata sul dispositivo: il metodo prevede le richieste agli strumenti a partire da ipotesi parziali del riconoscimento automatico del parlato (ASR) e ne avvia l’esecuzione mentre il parlato viene ancora ricevuto, riducendo così la latenza complessiva della risposta. Il nostro approccio introduce un modulo Predictor che anticipa le chiamate agli strumenti durante il riconoscimento del parlato, le esegue in modo speculativo e memorizza i risultati nella cache. I risultati memorizzati vengono poi inseriti nel prompt dell’LLM, consentendo risposte più rapide. Inoltre, per mitigare gli errori causati dalle autocorrezioni dell’utente mentre parla, impieghiamo un meccanismo di validazione basato su regole che inserisce selettivamente solo i risultati validi presenti nella cache. Come ultima garanzia, l’LLM conserva la possibilità di effettuare direttamente chiamate agli strumenti, assicurando che, nel caso peggiore, la latenza del nostro framework non superi quella della pipeline di base a esecuzione seriale. Valutiamo il metodo mediante misurazioni dal vivo effettuate su un assistente vocale Android pienamente implementato. Il nostro approccio riduce il tempo mediano fino al primo audio da 5,79 s a 4,60 s e la deviazione standard da 3,49 s a 2,81 s, rendendo più prevedibile la latenza della risposta.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv