Ricerca
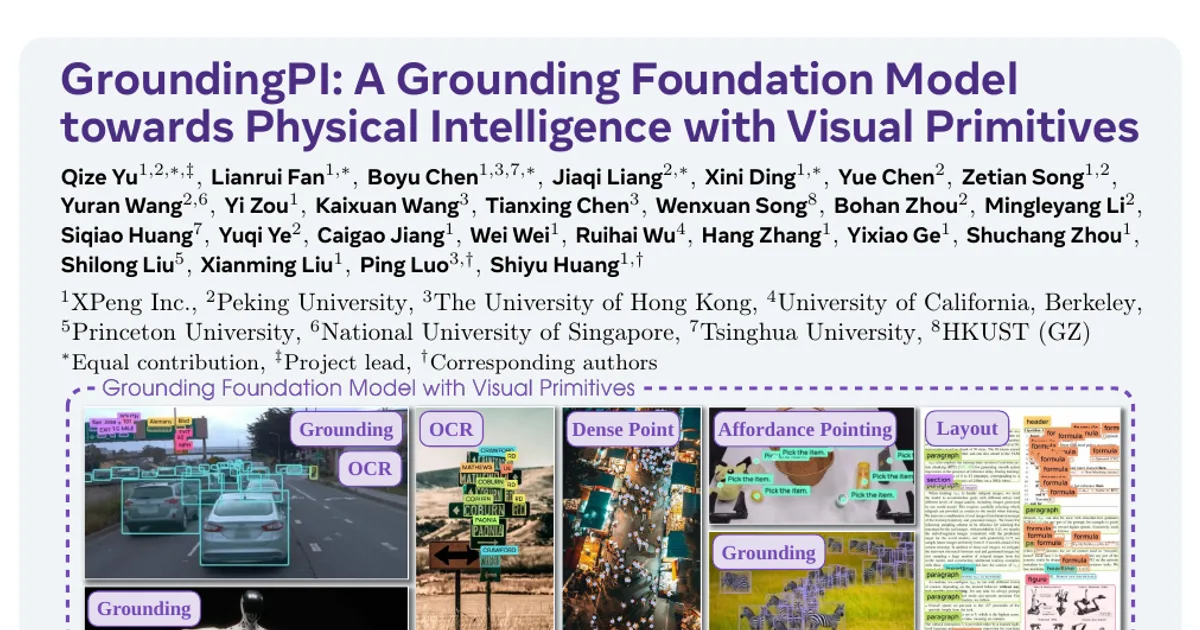
GroundingPI: un modello di base per il grounding orientato all’intelligenza fisica con primitive visive
La precisione del grounding è importante: permette di stabilire quale oggetto sia il bersaglio e dove si trovi, anche in scene affollate e nel caso di oggetti minuscoli. Deve inoltre essere abbastanza
- arXiv
- 2609.39601
- Pubblicato
- 2026-09-30
- Autori
- Qize Yu, Lianrui Fan, Boyu Chen, Jiaqi Liang, Xini Ding, Yue Chen, Zetian Song, Yuran Wang, Yi Zou, Kaixuan Wang, Tianxing Chen, Wenxuan Song, Bohan Zhou, Mingleyang Li, Siqiao Huang, Yuqi Ye, Caigao Jiang, Wei Wei, Ruihai Wu, Hang Zhang, Yixiao Ge, Shuchang Zhou, Shilong Liu, Xianming Liu, Ping Luo, Shiyu Huang
Abstract degli autori
La precisione del grounding è importante: permette di stabilire quale oggetto sia il bersaglio e dove si trovi, anche in scene affollate e nel caso di oggetti minuscoli. Deve inoltre essere abbastanza rapido da consentire il controllo ad anello chiuso. Eppure i modelli visione-linguaggio-azione (VLA) e i modelli mondo-azione (WAM) affidano la percezione a modelli di base generalisti per la visione e il linguaggio e per la generazione di video, che in queste condizioni continuano a fallire. Presentiamo GroundingPI, un modello di base per il grounding da 4 miliardi di parametri che genera punti e riquadri sotto forma di coordinate quantizzate in un vocabolario condiviso. L’addestramento combina preaddestramento multimodale e spaziale, fine-tuning supervisionato e apprendimento per rinforzo con GRPO, usando dati supervisionati provenienti da dataset pubblici e da sistemi dedicati alla produzione di dati. Nel confronto con 44 baseline su 34 benchmark di grounding che coprono 11 capacità percettive, GroundingPI stabilisce un nuovo stato dell’arte, con una media del 73,68%, superiore a quella del più grande GPT-6 Astra (71,54%). Usato come backbone visivo per compiti successivi, GroundingPI migliora le prestazioni nella manipolazione robotica e nella guida autonoma. Su RoboTwin 2.0 supera tutti i backbone più diffusi che abbiamo valutato in ciascuna delle quattro condizioni fuori distribuzione, con un vantaggio fino al 24,8% rispetto al backbone migliore. Su RoboCasa-GR1, GroundingPI addestrato con il 50% delle dimostrazioni supera quelle baseline addestrate con il 75%. Su nuScenes, usato come backbone visivo, GroundingPI ottiene un errore L2 medio ad anello aperto di 0,296 m. Analizziamo sistematicamente il preaddestramento di GroundingPI in termini di scala e composizione dei dati. Le prestazioni nella guida autonoma e nella manipolazione robotica migliorano con l’aumentare della scala del preaddestramento. L’analisi della composizione dei dati per queste 11 capacità percettive mostra i notevoli benefici del grounding denso per entrambe le applicazioni e il potenziale dell’OCR come catalizzatore dell’apprendimento percettivo. Questi risultati confermano il grounding come fondamento percettivo e indicano nel preaddestramento percettivo dedicato una direzione promettente per i modelli di base dell’intelligenza fisica.