Ricerca
Dal pretraining alla competenza: RL su sottocompiti reali per la manipolazione a orizzonte lungo con un intervento umano minimo
Una policy fondazionale per robot, preaddestrata, può eseguire gran parte di un compito a orizzonte lungo, ma fallire ripetutamente in alcuni sottocompiti critici. Raccogliere ulteriori dimostrazioni
- arXiv
- 2609.21788
- Pubblicato
- 2026-09-18
- Autori
- Sichang Su, Benjamin Yang, Zhiyun Deng, Boyuan Liang, Yip Fun Yeung, Zelin Wang, Lingfeng Sun
Abstract degli autori
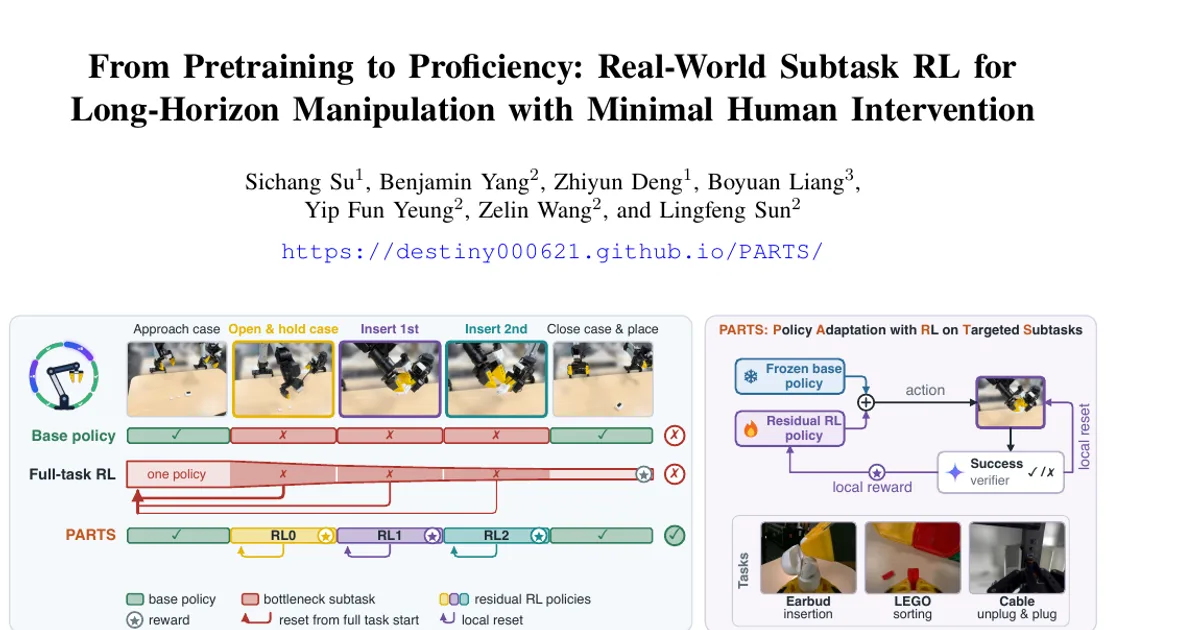
Una policy fondazionale per robot, preaddestrata, può eseguire gran parte di un compito a orizzonte lungo, ma fallire ripetutamente in alcuni sottocompiti critici. Raccogliere ulteriori dimostrazioni dell’intero compito per il fine-tuning supervisionato (SFT) richiede agli operatori di ripetere comportamenti che la policy esegue già bene. Il fine-tuning con apprendimento per rinforzo (RL) offre una strada promettente per colmare questo divario, ma gli approcci esistenti faticano a risolvere compiti a orizzonte lungo usando solo ricompense sparse. Presentiamo PARTS (Policy Adaptation with RL on Targeted Subtasks), un framework di RL su sottocompiti nel mondo reale che concentra l’addestramento sui punti critici, consentendo al contempo lo svolgimento dei rollout di training con un intervento umano minimo. La policy preaddestrata e congelata fornisce azioni nominali per tutta l’esecuzione, mentre selettori e verificatori del successo generati dall’agente attivano correzioni residue e forniscono ricompense locali in base all’esito. Queste ricompense permettono di apprendere dai sottocompiti riusciti anche quando i successi dell’intero compito sono rari. L’addestramento combina RL online e riaddestramento ripesato in base al successo; ogni policy residua riaddestrata viene poi ridistribuita per raccogliere ulteriore esperienza. Durante la configurazione, gli esseri umani individuano i punti critici ed eseguono i reset fisici quando necessario. Nei compiti bimanuali YAM e in quelli con il braccio singolo Franka, PARTS aumenta il tasso di successo dell’intero compito rispettivamente dal 32% al 61% e dal 50% al 95%, con una media di alcune decine di minuti di rollout di RL nel mondo reale per compito. Rispetto ai metodi esistenti di fine-tuning con RL nel mondo reale, PARTS aumenta di oltre 25% il tasso di successo dell’intero compito a parità di budget di rollout del robot, richiedendo al contempo un minore coinvolgimento umano.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv