Ricerca
Dalla causa all’effetto: generare catene di eventi intermedi nei video
I modelli video-linguistici (VLM) eccellono nel riconoscimento visivo, ma faticano nel ragionamento causale. Le valutazioni attuali presentano dei limiti: le domande a scelta multipla consentono scorc
- arXiv
- 2610.26275
- Pubblicato
- 2026-10-19
- Autori
- Ridouane Ghermi, Vicky Kalogeiton, Ivan Laptev
Abstract degli autori
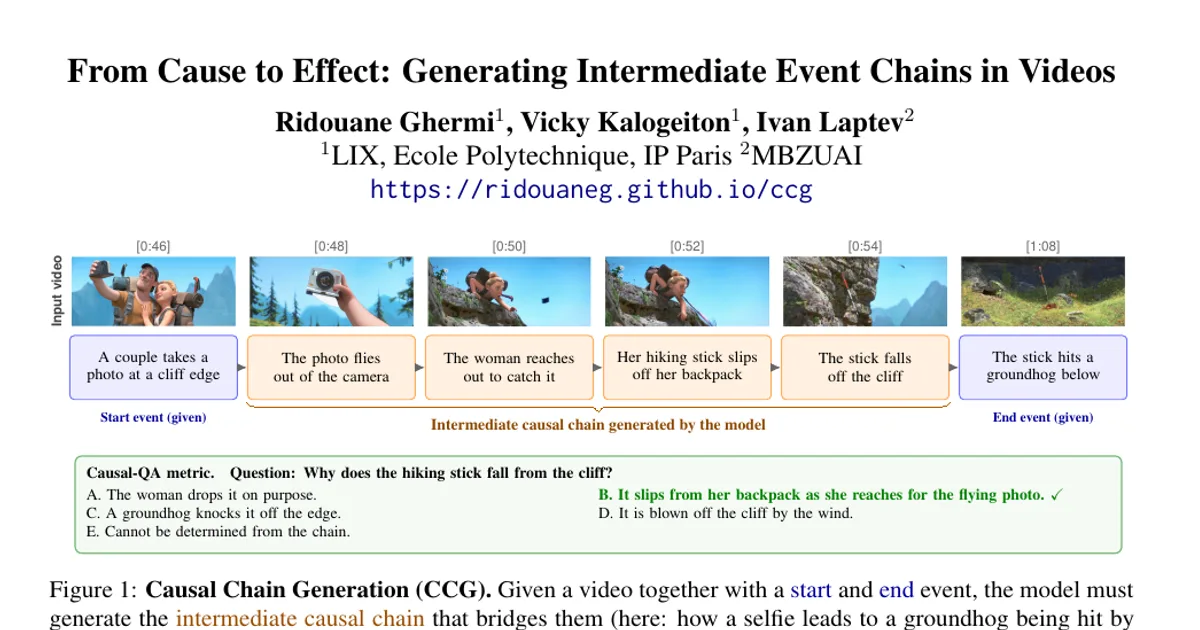
I modelli video-linguistici (VLM) eccellono nel riconoscimento visivo, ma faticano nel ragionamento causale. Le valutazioni attuali presentano dei limiti: le domande a scelta multipla consentono scorciatoie, mentre quelle a risposta aperta non permettono una valutazione automatica robusta. Introduciamo Causal Chain Generation (CCG), un nuovo compito in cui i modelli devono generare la sequenza di eventi intermedi che collega una causa a un effetto. Questa impostazione strutturata richiede un autentico ragionamento e consente di attribuire punteggi affidabili in modo automatico. Al compito affianchiamo due metriche complementari: SODA-Embedding, che misura la corrispondenza semantica tra una catena generata e una di riferimento, e Causal-QA, che verifica la coerenza causale della catena chiedendo se contenga i fatti causali specifici necessari a ricostruire la narrazione. Forniamo due set di test: SF20K-CC, un set diagnostico annotato manualmente su 20 cortometraggi, e CMD-CC, un benchmark di clip cinematografiche ricavato dalle audiodescrizioni. La nostra analisi rivela che i VLM più avanzati faticano a comprendere la causalità narrativa: spesso inventano eventi o ne omettono di fondamentali. Per affrontare il problema, sottoponiamo i VLM a fine-tuning con GRPO, usando una ricompensa composita che combina una ricompensa per il formato, SODA-Embedding e l’accuratezza di Causal-QA, e mostriamo miglioramenti sostanziali rispetto a solide baseline.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv