Ricerca
FoldQuantVLA: quantizzazione nativa a pochi bit dei modelli di visione-linguaggio-azione tramite folding coerente
L’inferenza a pochi bit dei modelli di visione-linguaggio-azione deve ridurre la latenza dal rilevamento all’azione preservando il comportamento del robot. Presentiamo FoldQuantVLA, un framework di qu
- arXiv
- 2609.24433
- Pubblicato
- 2026-09-21
- Autori
- Hung T. Ho, Khanh D. Nguyen, Quang D. Nguyen, Thanh Q. Duong, Ngan Le, Meng Guo, Vien A. Ngo, An T. Le
Abstract degli autori
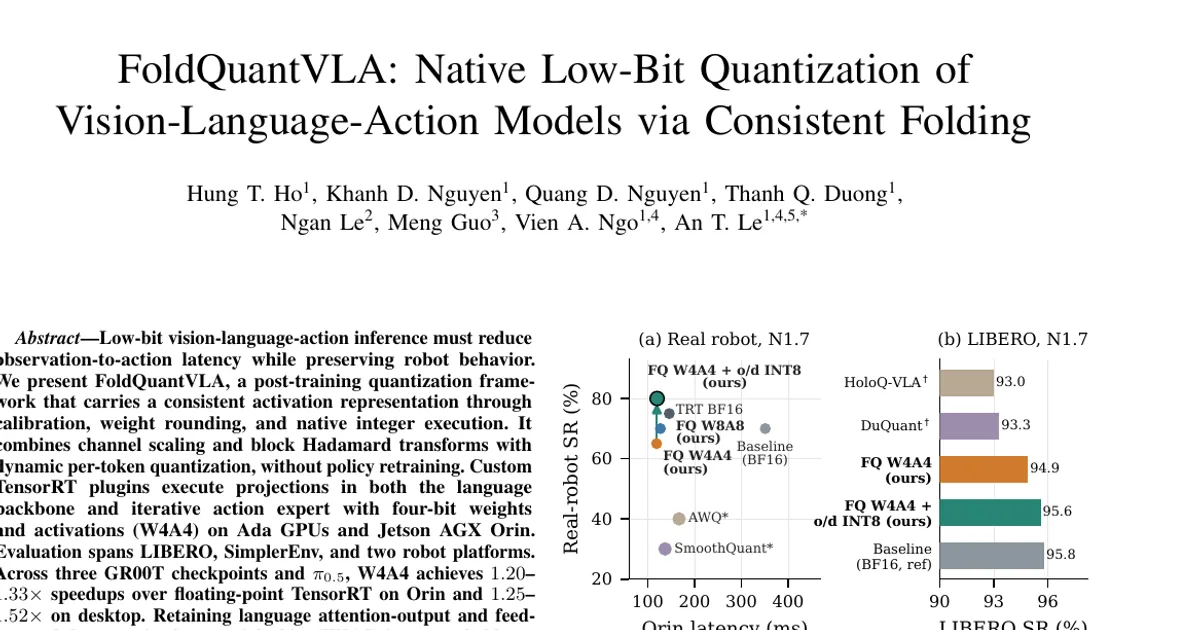
L’inferenza a pochi bit dei modelli di visione-linguaggio-azione deve ridurre la latenza dal rilevamento all’azione preservando il comportamento del robot. Presentiamo FoldQuantVLA, un framework di quantizzazione post-training che mantiene una rappresentazione coerente delle attivazioni durante la calibrazione, l’arrotondamento dei pesi e l’esecuzione nativa con interi. Combina la scalatura dei canali e le trasformazioni di Hadamard a blocchi con la quantizzazione dinamica per token, senza riaddestrare la policy. Plugin personalizzati per TensorRT eseguono le proiezioni sia nel backbone linguistico sia nell’esperto d’azione iterativo con pesi e attivazioni a quattro bit (W4A4) su GPU Ada e Jetson AGX Orin. La valutazione comprende LIBERO, SimplerEnv e due piattaforme robotiche. Sui tre checkpoint GR00T e su $π_{0.5}$, W4A4 raggiunge accelerazioni da $1.20$ a $1.33\times$ rispetto a TensorRT in virgola mobile su Orin, e da $1.25$ a $1.52\times$ su desktop. Mantenere a otto bit le proiezioni di output dell’attenzione linguistica e quelle down feed-forward (W8A8) migliora la fedeltà delle azioni su dati esclusi per tutti e quattro i checkpoint. In quattro compiti eseguiti con robot reali, questa configurazione porta il tasso di successo osservato di GR00T N1.7 dall’$80.0\%$ con W4A4 uniforme al $92.5\%$ su 80 prove per configurazione, con un aumento misurato della latenza su Orin di 1 ms.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv