Ricerca
FoldingAgent: inferire procedure parametriche per gli origami dai video dimostrativi
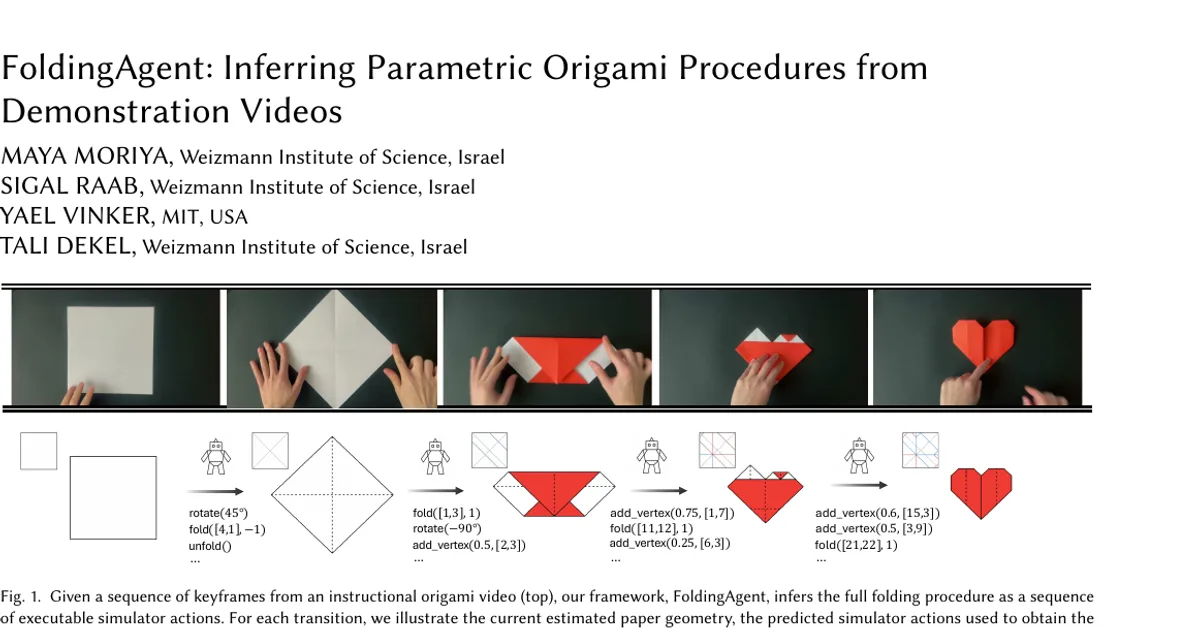
Presentiamo FoldingAgent, un framework basato su agenti che ricava programmi parametrici espliciti di piegatura direttamente dai video dimostrativi di origami. Il framework sfrutta le capacità di ragi
- arXiv
- 2609.00377
- Pubblicato
- 2026-08-31
- Autori
- Maya Moriya, Sigal Raab, Yael Vinker, Tali Dekel
Abstract degli autori
Presentiamo FoldingAgent, un framework basato su agenti che ricava programmi parametrici espliciti di piegatura direttamente dai video dimostrativi di origami. Il framework sfrutta le capacità di ragionamento di un modello visivo-linguistico (VLM) preaddestrato, dotato di strumenti specializzati che consentono all’agente di simulare le transizioni geometriche, verificare la plausibilità fisica, recuperare e confrontare contenuti visivi e valutare le proprie previsioni. Per tradurre il contenuto visivo in programmi di piegatura, definiamo uno spazio parametrico composto dalla geometria della carta e da un insieme di azioni parametriche di piegatura. A differenza dei modelli che prevedono schemi statici delle pieghe, il nostro agente opera in sequenza ed è in grado di ripianificare le proprie azioni, attenuando così gli errori che si accumulano nei processi di piegatura a più passaggi. Il nostro approccio compie un passo verso il superamento del divario tra le conoscenze umane sugli origami, trasmesse principalmente attraverso dimostrazioni visive non strutturate, e i metodi computazionali, che in genere si basano su rappresentazioni strutturate e parametriche, come uno schema delle pieghe o un piano parametrico eseguibile. Valutiamo il nostro approccio su PurelandFold, un nuovo benchmark di video eterogenei di origami Pureland, corredati dalla geometria di riferimento e dalle etichette delle azioni. I risultati dimostrano che, combinando il ragionamento del VLM con strumenti specializzati e simulazione fisica, possiamo trasformare con successo dimostrazioni visive non strutturate in procedure di piegatura eseguibili e fisicamente plausibili.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv