Ricerca
FlashRender: rendering generativo in pochi passaggi tramite MeanFlow per video con controllo della camera
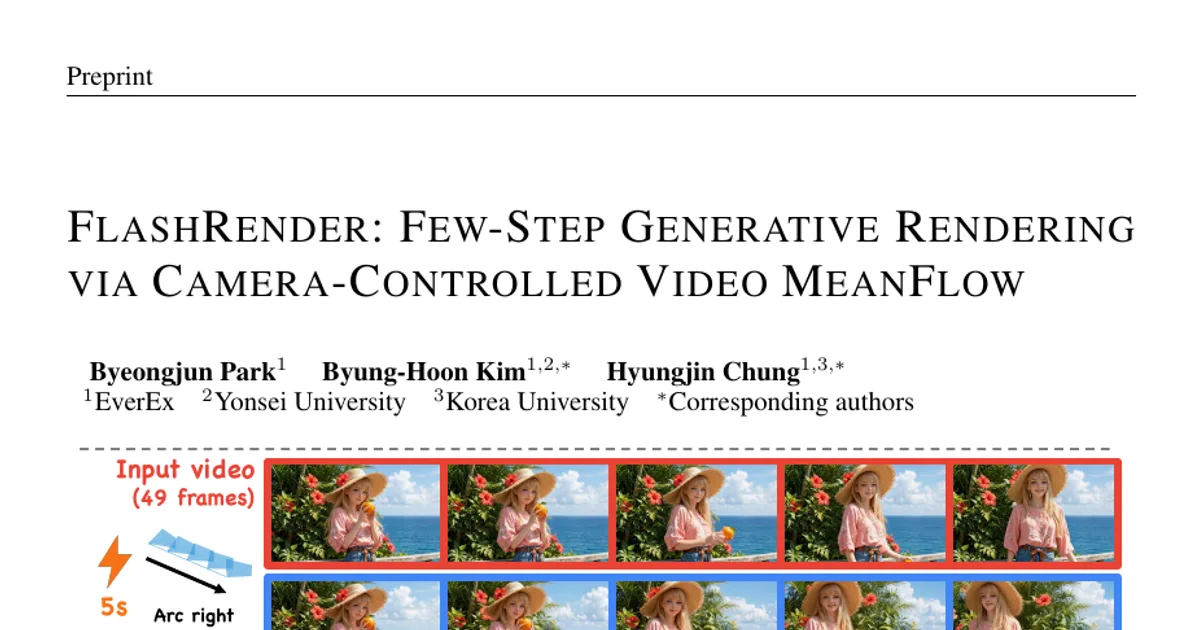
Presentiamo FlashRender, un framework di rendering generativo in pochi passaggi che rigira un video sorgente seguendo una traiettoria prestabilita della camera in pochi secondi. Individuiamo nel contr
- arXiv
- 2609.03563
- Pubblicato
- 2026-09-03
- Autori
- Byeongjun Park, Byung-Hoon Kim, Hyungjin Chung
Abstract degli autori
Presentiamo FlashRender, un framework di rendering generativo in pochi passaggi che rigira un video sorgente seguendo una traiettoria prestabilita della camera in pochi secondi. Individuiamo nel controllo della camera che varia in base al numero di passaggi di campionamento una manifestazione evidente dell’errore di discretizzazione nei modelli di rendering generativo a più passaggi esistenti e mostriamo che eliminare questa incoerenza riduce sostanzialmente la curvatura della traiettoria di denoising, facilitando la successiva distillazione dei passaggi. A questo scopo introduciamo Representation Transformation and Alignment (RETA), che allinea le rappresentazioni interne del video sorgente con le caratteristiche del video di destinazione ricavate da un modello di geometria visiva con parametri congelati. RETA codifica così direttamente la trasformazione geometrica nel flusso del video sorgente, rendendo il controllo della camera coerente al variare del numero di passaggi di campionamento. Eseguiamo poi il fine-tuning del modello con l’obiettivo MeanFlow sulla traiettoria di denoising a curvatura ridotta prodotta da RETA, consentendo al modello di affrontare più efficacemente l’errore di discretizzazione. Infine, applichiamo la distillazione on-policy della mappa di flusso per correggere gli errori prodotti dai rollout del modello stesso con un campionamento a pochi passaggi prefissati. Numerosi esperimenti mostrano che RETA, MeanFlow e la distillazione on-policy della mappa di flusso svolgono ruoli complementari nel rendering generativo in pochi passaggi. Insieme, consentono al nostro approccio di eguagliare i modelli di riferimento a più passaggi per qualità video e coerenza geometrica, con un costo di campionamento 25 volte inferiore, e di ottenere al tempo stesso un controllo della camera superiore, anche con traiettorie prestabilite della camera al di fuori della distribuzione dei dati di addestramento.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv