Ricerca
FinHopper: un benchmark multi-hop progressivo per agenti finanziari complessi con valutazione passo per passo
Ci si aspetta che gli agenti finanziari rispondano a domande fattuali sugli investimenti ricorrendo alla ricerca aperta, ma il reperimento di informazioni finanziarie multi-hop differisce dalla rispos
- arXiv
- 2610.26036
- Pubblicato
- 2026-10-19
- Autori
- Yuxuan Wu, Miaopei Lin, Qiufang Ying, Lin Dan, Hao Zhao, Qirui Liu, Yuteng Shen, Shaohui Wu, Weihong Luo, Xiku Du, Xing Tang, Hao Chen
Abstract degli autori
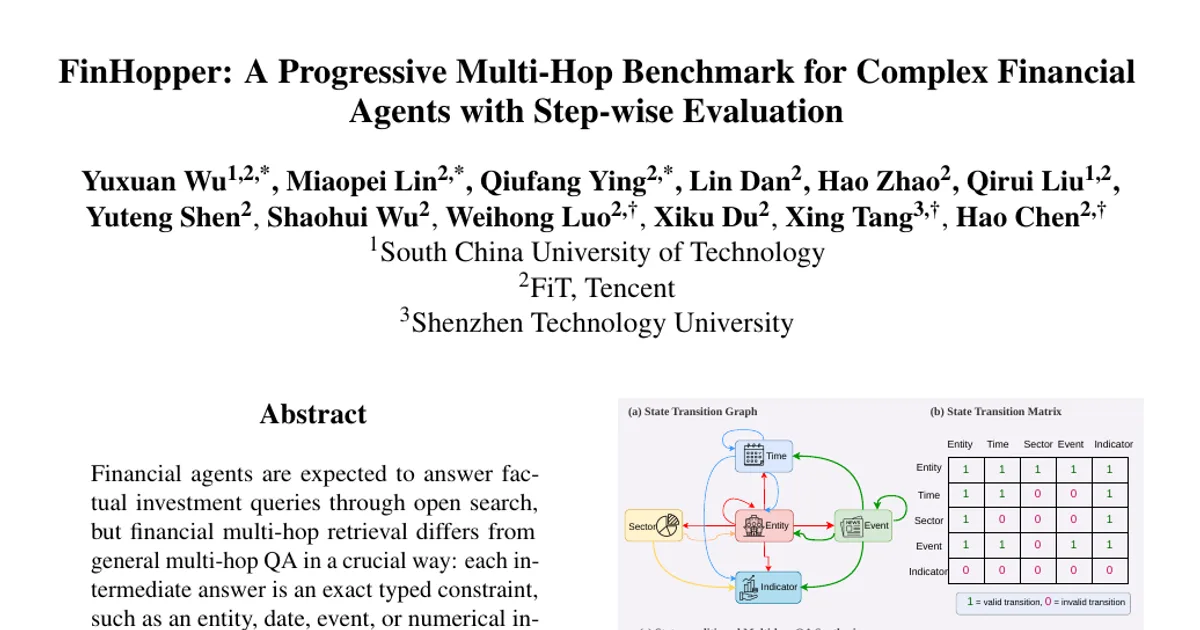
Ci si aspetta che gli agenti finanziari rispondano a domande fattuali sugli investimenti ricorrendo alla ricerca aperta, ma il reperimento di informazioni finanziarie multi-hop differisce dalla risposta a domande multi-hop di carattere generale per un aspetto cruciale: ogni risposta intermedia è un vincolo esatto e tipizzato, come un’entità, una data, un evento o un indicatore numerico, che determina la ricerca successiva. Questa rigida dipendenza dalle risposte fa sì che piccoli errori intermedi si propaghino, producendo percorsi di ricerca plausibili ma errati. Presentiamo FinHopper, un benchmark per agenti finanziari complessi con una profondità di ragionamento controllata da 1 a 6 passaggi, che copre azioni, fondi e dati macroeconomici e fornisce risposte intermedie di riferimento per valutare il processo. Per costruire FinHopper su larga scala, progettiamo un sistema di sintesi basato sulle transizioni di stato che combina schemi verificati di domande e risposte finanziarie elementari in catene che preservano le dipendenze. Seguono una verifica mirata durante la sintesi, un controllo mediante un insieme di modelli e una validazione tramite ricerca pubblica condotta da esperti finanziari. Gli esperimenti con 20 configurazioni di agenti basati su LLM mostrano che gli strumenti di ricerca pubblici sono necessari ma non sufficienti: le prestazioni calano nettamente all’aumentare del numero di passaggi, il modello migliore resta molto al di sotto degli esperti umani e una valutazione che tiene conto del processo rivela progressi parziali nel ragionamento che una valutazione limitata alla risposta finale non rileva. Il benchmark è disponibile all’indirizzo https://github.com/justajustin/FinHopper/.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv