Ricerca
EvoSafeHarness: evoluzione di sistemi di protezione specifici per modello e dominio per la sicurezza degli agenti
Gli agenti basati su modelli linguistici di grandi dimensioni (LLM) trasformano il linguaggio in effetti nel mondo reale: servono quindi misure di sicurezza sia contro le prompt injection indirette si
- arXiv
- 2609.05903
- Pubblicato
- 2026-09-05
- Autori
- Nanxi Li, Yingzi Ma, Yulong Cao, Edward Suh, Bo Li, Dawn Song, Chaowei Xiao
Abstract degli autori
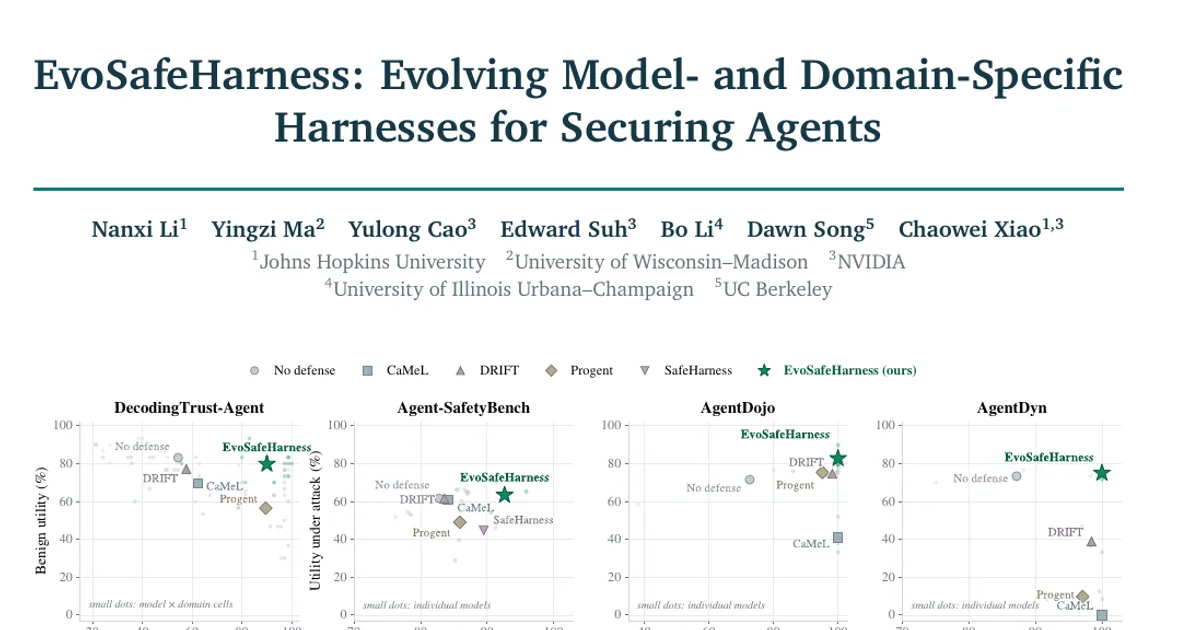
Gli agenti basati su modelli linguistici di grandi dimensioni (LLM) trasformano il linguaggio in effetti nel mondo reale: servono quindi misure di sicurezza sia contro le prompt injection indirette sia contro le richieste dannose dirette. I sistemi di protezione a livello di sistema aggiungono un livello di applicazione delle regole oltre alle difese a livello di modello, ma quelli esistenti sono di solito progettati una sola volta da esperti e applicati a modelli e domini eterogenei. Una protezione efficace dipende dal contesto di impiego: i modelli differiscono per quanto rigorosa debba essere l’applicazione delle regole prima che l’utilità diminuisca, mentre i domini differiscono per gli effetti, gli stati e le sequenze di azioni da governare. Un sistema abbastanza rigoroso per un modello può bloccare eccessivamente un altro; una policy trasferibile tra domini può invece non cogliere le relazioni di sicurezza specifiche di un’applicazione. Presentiamo EvoSafeHarness, un framework di ottimizzazione specifico per la sicurezza che genera un sistema di protezione utilizzabile per un modello non modificabile in un dominio di destinazione. Il framework ricerca congiuntamente una policy in linguaggio naturale e una logica eseguibile in codice, guidato dal comportamento del modello, dalle specifiche del dominio e da una verifica avversariale in un contesto nuovo, volta a scartare le regole specifiche per i benchmark. In quattro famiglie di benchmark per agenti, EvoSafeHarness ottiene un migliore equilibrio tra sicurezza e utilità rispetto alle difese fisse progettate da esperti. Su DecodingTrust-Agent riduce il tasso medio di successo degli attacchi dal 45,6% al 10,0%, a un costo di 3,3 punti in termini di utilità, e ottiene il punteggio migliore in 14 celle su 15. Su AgentDojo raggiunge un’utilità dell’82,8% con un ASR dello 0,0%, il doppio dell’utilità di CaMeL allo stesso punto operativo, e si trasferisce senza modifiche a suite AgentDyn mai viste. Ottiene inoltre il punteggio migliore su Agent-SafetyBench per ogni vittima e mantiene l’ASR medio sotto il 20% contro attacchi PAIR adattivi con un budget di perfezionamento pari a 16. L’analisi mostra che la semantica del dominio determina quali relazioni di sicurezza e quali stati della traiettoria siano necessari, mentre il comportamento del modello e dell’ambiente di esecuzione determina come e dove tali relazioni debbano essere fatte rispettare.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv