Ricerca
Valutare l’apprendimento basato sull’indagine negli agenti basati su LLM: formulazione di ipotesi, ragionamento ed esplorazione
L’indagine scientifica procede per cicli iterativi di esplorazione, formulazione di ipotesi e ragionamento a partire dalle osservazioni, per individuare le relazioni nei sistemi complessi. I modelli l
- arXiv
- 2610.21604
- Pubblicato
- 2026-10-15
- Autori
- Marta Knežević, Seyed Parsa Neshaei, Jibril Frej, Vinitra Swamy, Tanja Käser
Abstract degli autori
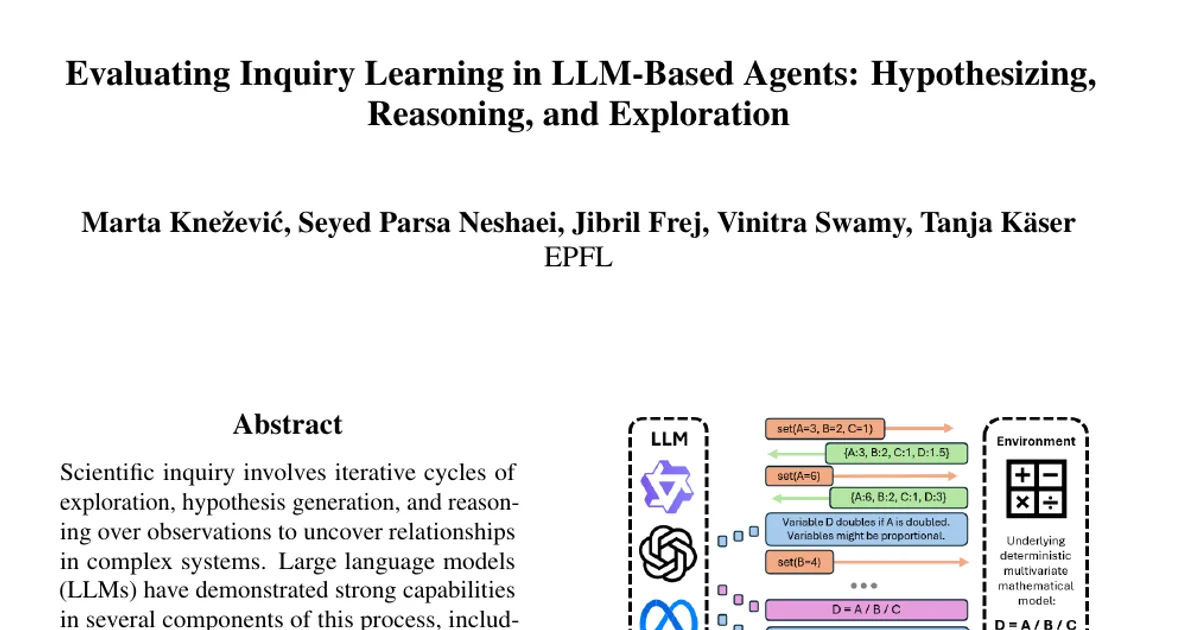
L’indagine scientifica procede per cicli iterativi di esplorazione, formulazione di ipotesi e ragionamento a partire dalle osservazioni, per individuare le relazioni nei sistemi complessi. I modelli linguistici di grandi dimensioni (LLM) hanno dimostrato notevoli capacità in diverse componenti di questo processo, tra cui il ragionamento induttivo, la formulazione di ipotesi e l’analisi dei dati. Tuttavia, gli studi precedenti valutano generalmente queste capacità in modo isolato, lasciando aperta la questione di come i modelli le integrino nell’intero ciclo di indagine. In questo lavoro presentiamo un quadro per valutare le capacità di indagine degli LLM in un contesto unitario e interattivo. Estendiamo il compito Countdown a un ambiente matematico in cui un agente sonda il sistema manipolando variabili, raccogliendo osservazioni e deducendo le relazioni tra di esse. Questa impostazione consente di analizzare le strategie di esplorazione, la scoperta di relazioni causali e il perfezionamento delle ipotesi durante l’indagine. Gli esperimenti condotti su sette LLM e con diverse strategie di prompting rivelano capacità intrinseche di indagine limitate e basse percentuali di successo nell’individuare le espressioni sottostanti. Una guida strutturata, ispirata allo scaffolding didattico, migliora però significativamente le prestazioni. I nostri risultati mettono in luce gli attuali limiti degli LLM nell’esplorazione strategica e nel perfezionamento iterativo delle ipotesi, e mostrano come semplici strategie di guida sviluppate per chi apprende attraverso l’indagine possano favorire un comportamento di indagine più efficace.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv