Ricerca
EditaLive: modifica unificata dei video dei personaggi per le dirette streaming
La modifica video tradizionale si concentra soprattutto sui contenuti a livello di scena, mentre nelle dirette streaming l’attenzione è rivolta maggiormente alla persona. Applicare direttamente i meto
- arXiv
- 2608.27123
- Pubblicato
- 2026-08-27
- Autori
- Zhiyuan Li, Chi-Man Pun, Peng-Tao Jiang, Bo Li, Xiaodong Cun
Abstract degli autori
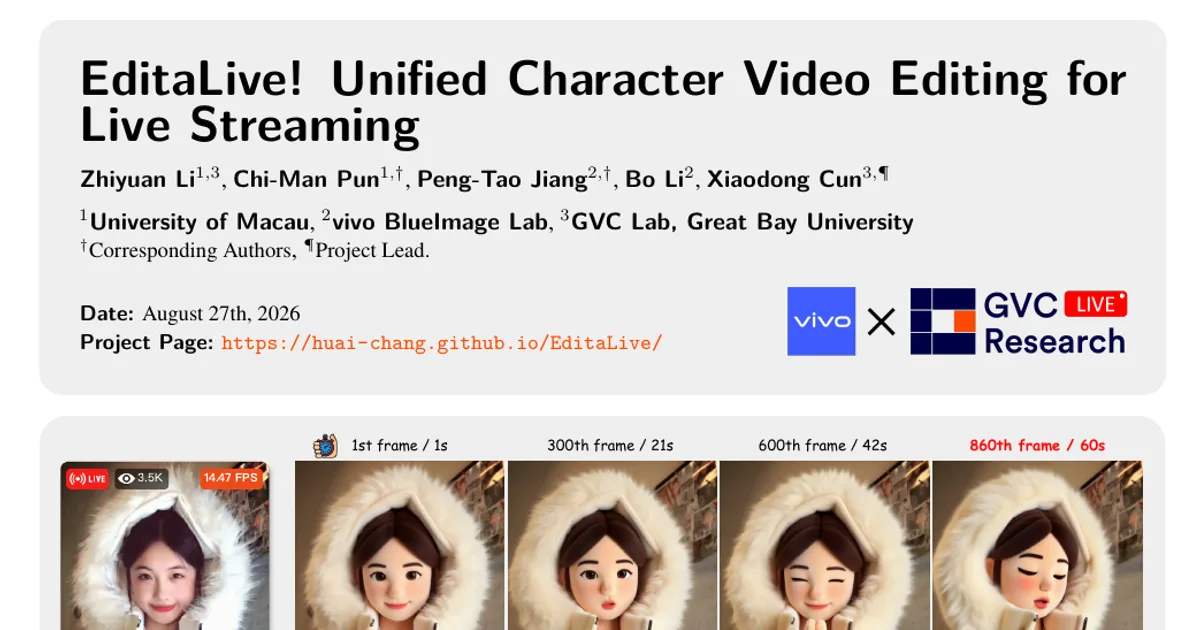
La modifica video tradizionale si concentra soprattutto sui contenuti a livello di scena, mentre nelle dirette streaming l’attenzione è rivolta maggiormente alla persona. Applicare direttamente i metodi di modifica video esistenti alle dirette streaming incentrate sulle persone resta però difficile: questi metodi possono introdurre incoerenze nelle espressioni facciali e richiedono in genere più passaggi di inferenza offline, risultando inadatti all’interazione in tempo reale. Proponiamo EditaLive, un nuovo framework per la modifica in tempo reale dei video dei personaggi trasmessi in streaming. Partiamo da un modello preaddestrato per l’animazione delle immagini (Wan-Animate), che separa naturalmente l’aspetto dal movimento, e lo riutilizziamo come modello di base per la modifica, guidata da istruzioni, di video incentrati sulle persone: modifichiamo un fotogramma di riferimento e ricostruiamo il video utilizzando il dataset CharEdit-50K, da noi raccolto. Inoltre, adattiamo il modello dalla generazione bidirezionale offline alla generazione causale in streaming e progettiamo una strategia di distillazione mediante self-rollout allineato che lo comprime in un campionatore a due passaggi. Il RoPE fisso e la forzatura dell’allineamento riducono le discrepanze tra addestramento e inferenza, mentre un meccanismo di attenzione sparsa che preserva il primo fotogramma filtra le informazioni storiche ridondanti per limitare la deriva dell’aspetto. Numerosi esperimenti dimostrano che EditaLive offre prestazioni di modifica allo stato dell’arte, preserva fedelmente le espressioni facciali e consente un’inferenza in streaming in tempo reale a bassa latenza.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv