Ricerca
A ciascuna ricompensa i token pertinenti: attribuzione del merito a livello di token specifica per ciascuna ricompensa nell’apprendimento per rinforzo con ricompense multiple
I modelli linguistici vengono sempre più spesso addestrati sulla base di più ricompense verificabili contemporaneamente, come la correttezza e il formato di una chiamata a uno strumento, oppure i sing
- arXiv
- 2610.21439
- Pubblicato
- 2026-10-15
- Autori
- Skylar Zhai, Haonan Wang, Zhining Liu, Linxin Song, Xuwei Ding, Jingcheng Liang, Jian Kang
Abstract degli autori
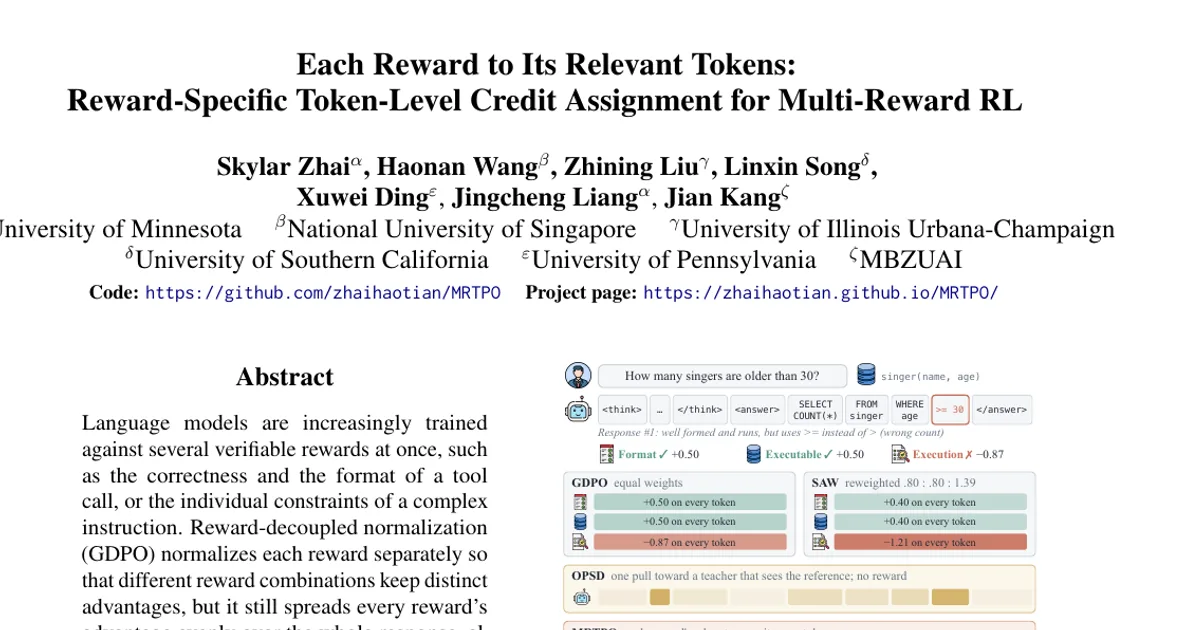
I modelli linguistici vengono sempre più spesso addestrati sulla base di più ricompense verificabili contemporaneamente, come la correttezza e il formato di una chiamata a uno strumento, oppure i singoli vincoli di un’istruzione complessa. La normalizzazione separata delle ricompense (GDPO) normalizza ciascuna ricompensa per conto proprio, così che combinazioni diverse di ricompense mantengano vantaggi distinti. Continua però a distribuire uniformemente il vantaggio di ogni ricompensa sull’intera risposta, sebbene ciascun verificatore controlli solo poche posizioni. Proponiamo MRTPO, che attribuisce il vantaggio di ciascuna ricompensa ai token pertinenti, utilizzando le informazioni controllate dal relativo verificatore, senza modelli ausiliari né annotazioni a livello di token. Per ciascuna ricompensa, la policy ripercorre la propria risposta con e senza le informazioni del verificatore relative a quella ricompensa. La distanza di Jensen-Shannon per ciascun token tra le due distribuzioni del token successivo misura la pertinenza di ogni token e permette di riassegnare il vantaggio. Nei compiti di text-to-SQL, esecuzione di istruzioni con più vincoli e chiamata a strumenti, MRTPO converge più rapidamente e ottiene prestazioni migliori rispetto ai metodi con cui viene confrontato.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv